El popular sitio de subtítulos de películas y series, OpenSubtitles, anunció esta semana a sus usuarios que había sido atacado por un hacker, alertó a los usuarios el martes 18 de enero después de que el hacker filtró la base de datos en línea.
En una publicación de blog en su foro, el equipo del sitio reveló que un hacker los contactó en agosto pasado a través de Telegram para informarles que tenía acceso a los datos de todos los usuarios, aproximadamente 7 millones, incluidas direcciones de correo electrónico e IP, nombres de usuario y contraseñas.
Para quienes desconocen de OpenSubtitles, deben saber que es un servicio muy popular que ofrece archivos de subtítulos de películas y series. El servicio es accesible a través de los dominios «opensubtitles.org» y «opensubtitles.com», donde mantiene un foro de discusión.
Según el mensaje de los administradores del sitio los hackers pudieron acceder a la base de datos de usuarios en agosto de 2021. Dado que los operadores de OpenSubtitles no respondieron a las demandas de rescate, los datos de acceso ahora aparecen en Internet. Según el equipo, la base de datos de usuarios comprende poco más de 6,7 millones de entradas.
El paquete filtrado contiene direcciones de correo electrónico, IP, nombres de usuario, países de origen de los usuarios y contraseñas en forma de un hash MD5. El equipo admite que se ha hecho poco para reforzar la seguridad en los últimos años, lo que permitió al atacante realizar una inyección SQL después de comprometer la contraseña insegura de un superadministrador.
“En agosto de 2021, recibimos un mensaje en Telegram de un pirata informático, quien nos demostró que había podido acceder a la tabla de usuarios de opensubtitles.org y descargó un volcado de SQL (una copia de datos sin procesar). Exigió un rescate en bitcoins por no revelar esto al público y prometió eliminar los datos. Difícilmente aceptamos, porque no era una pequeña cantidad de dinero. Nos dijo cómo podía obtener acceso y nos ayudó a corregir el error. Técnicamente, logró hackear la contraseña insegura de un SuperAdmin”, dice la publicación del equipo.
“Tenía acceso a un script inseguro, que solo estaba disponible para SuperAdmins. Este script le permitió realizar inyecciones de SQL y extraer los datos”, decía la publicación. Si bien ninguno de los datos pirateados se filtró en agosto pasado, el 11 de enero de 2022, OpenSubtitles recibió más correspondencia de un «colaborador del pirata informático original» que hizo solicitudes similares. No fue posible ponerse en contacto con el pirata informático inicial para obtener ayuda, y el 15 de enero, el sitio se enteró de que los datos se habían filtrado en línea el día anterior.
El proyecto «Have-I-been-pwned?» registró los datos y los agregó a la base de datos de búsqueda de todas las fugas de datos públicos. Esto permite a los usuarios verificar si su dirección de correo electrónico o contraseña se ha visto comprometida.
OpenSubtitles dijo que la información de las tarjetas de crédito no se vieron comprometidas.
“El hacker puede obtener acceso a las cuentas de los usuarios. Entonces puede descargar subtítulos y demás, pero no ha tenido acceso a la tarjeta de crédito u otros datos; esos están almacenados fuera de nuestra plataforma”, escribió el administrador del sitio, “OSS”.
OpenSubtitles describe el hack como una «lección dura», reconociendo las fallas en su seguridad. Entonces, OpenSubtitles ha mejorado su seguridad desde entonces al hacer algunos cambios bajo el capó.
“El sitio almacenó las contraseñas en hashes md5() sin sal, que fueron reemplazados por hash_hmac y SHA-256 con sal”, dijo OSS. Además, OpenSubtitles también introdujo una nueva política de contraseñas, bloqueo de cuentas después de intentos fallidos de inicio de sesión, captcha en el restablecimiento de contraseña, página de inicio de sesión y otros lugares.
La amenaza más inmediata es para los usuarios que han usado la misma combinación de dirección de correo electrónico y contraseña en otros sitios. Un atacante podría así acceder a las cuentas de terceros. Asimismo, podría ser un problema para los usuarios de OpenSubtitles que frecuentan portales con las mismas credenciales.
Es por ello que si alguno de nuestros lectores es visitante frecuente, se recomienda que cambien su contraseña en los dominios openSubtitles.org y openSubtitles.com
Hace pocos dias fue dada a conocer la liberación de la nueva versión de la popular distribucion de Linux «Deepin 20.4» la cual aun continua bajo la base del paquete de Debian 10, pero desarrollando su propio entorno de escritorio Deepin (DDE) y unas 40 aplicaciones de usuario.
Esta nueva versión de Deepin 20.4 los kernels se actualizan con el upstream para una mejor compatibilidad y es que el kernel LTS se actualiza a la versión 5.10.83 y el kernel estable se actualiza a la versión 5.15.6, ademas de que se corrigieron algunas vulnerabilidades del sistema para mejorar la seguridad, asi como tambien que se desarrollaron y optimizaron muchas funciones para resolver los problemas de los usuarios y mejorar la experiencia del usuario.
Principales novedades de Deepin 20.4
En esta nueva versión que se presenta de Deepin 20.4 podremos encontrar de manera inicial que el instalador, se ha cambiado el acuerdo de «Política de privacidad» y se ha optimizado la lógica para crear particiones de disco (si hay una partición EFI, no se crea una nueva partición para EFI).
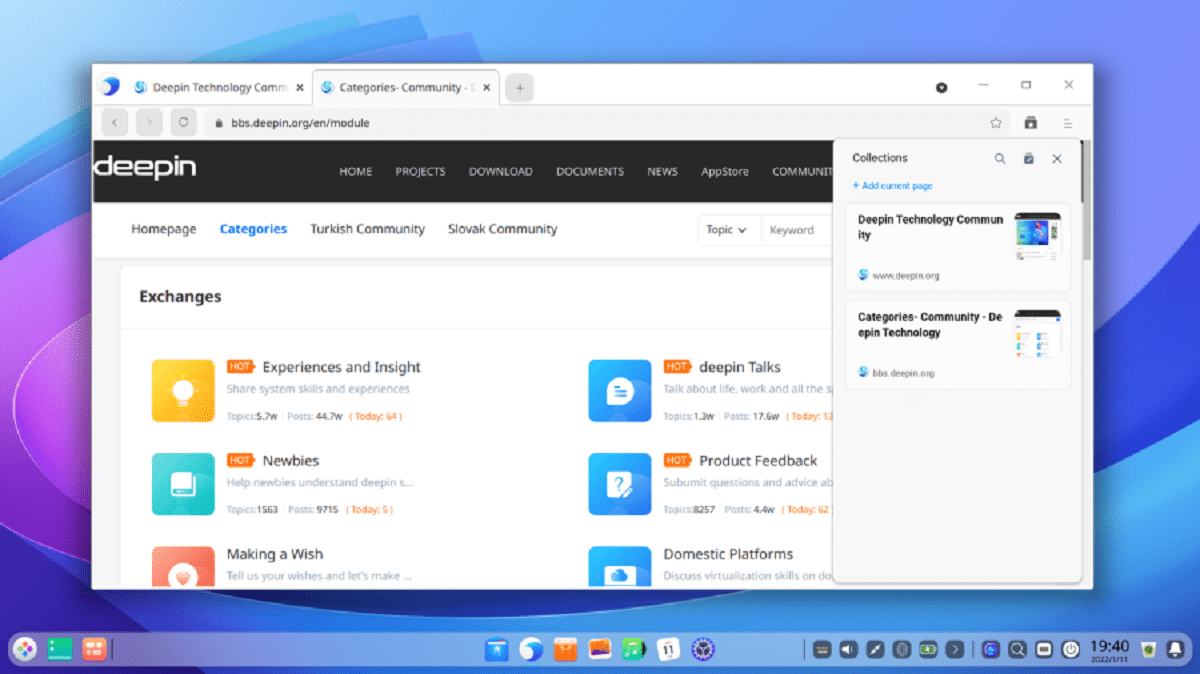
El navegador se migró del motor Chromium 83 a Chromium 93, ademas de que se agregó el soporte para la agrupación de pestañas, de colecciones, de búsqueda rápida en pestañas e intercambio de enlaces.
Otro de los cambios que se destaca de esta nueva versión de Deepin 20.4 es que se agregó un nuevo complemento para monitorear los parámetros del sistema a System Monitor, que le permite monitorear con mayor precisión la carga en la memoria y la CPU, y muestra notificaciones cuando se excede un umbral de carga específico o cuando se identifican procesos que consumen demasiados recursos.
La interfaz de «Gran Búsqueda» ahora se puede activar o desactivar en la configuración del panel. En los resultados de la búsqueda, fue posible mostrar las rutas de los archivos y directorios al hacer clic con la tecla Ctrl presionada.
Para los accesos directos en el escritorio, se aumentó la cantidad de caracteres que se muestran en el nombre del archivo, ademas de que se agregó la visualización de aplicaciones de terceros en el administrador de archivos en la página Computadora.
En la aplicación para trabajar con la cámara, se agregó la capacidad de cambiar la exposición y los filtros, y se proporcionó el estiramiento proporcional de las fotos durante la vista previa.
Se han agregado modos de limpieza de disco rápido, de seguridad y personalizado a la interfaz para trabajar con discos.
En los formularios de entrada de contraseña, se ha agregado una indicación de la seguridad de la contraseña.
De los demás cambios que se destacan de esta nueva versión:
Se agregó la capacidad de restaurar rápidamente un archivo movido a la papelera presionando Ctrl+Z.
Se agregó la opción «Redimensionar escritorio» al configurador para expandir el escritorio a pantalla completa en entornos de baja resolución.
Se agregaron configuraciones avanzadas de métodos de entrada.
Se ha implementado el modo de instalación automática de actualizaciones después de que se complete su descarga.
Se agregó soporte para autenticación biométrica
Se proporcionó montaje automático de particiones.
Los paquetes del kernel de Linux se han actualizado a las versiones 5.10.83 (LTS) y 5.15.6.
Por último para aquellos que estén interesados en poder conocer más al respecto de esta nueva versión, pueden consultar la publicación original en el siguiente enlace.
¿Como actualizar a Deepin 20.4?
Para todos aquellos que sean usuarios de alguna versión de Deepin OS que este dentro de la rama “20.x”. Podrán obtener esta nueva actualización sin la necesidad de tener que reinstalar el sistema.
Solamente tendrán que abrir una terminal en su sistema y ejecutar en ella los siguientes comandos:
Al finalizar la instalación de las actualizaciones el sistema, se recomienda que reinicien sus equipos.
Esto con el fin de que las nuevas actualizaciones instaladas sean cargadas y ejecutadas al inicio del sistema.
¿Cómo obtener Deepin 20.4?
Si no eres usuario de la distribución y quieres utilizarle en tu equipo o probarla en una máquina virtual.
Puedes obtener la imagen del sistema, solamente debes de dirigirte a la página web oficial del proyecto donde podrás descargar la imagen en su sección de descargas.
Al finalizar tu descarga puedes utilizar Etcher para grabar la imagen en un pendrive y así bootear tu sistema desde un USB.
Hace poco se dio a conocer la noticia de que Google ha eliminado la capacidad de eliminar los motores de búsqueda predeterminados del código base de Chromium, es decir todos aquellos motores de búsqueda que se encuentren por defecto en la lista del configurador, en la sección «Administrar motores de búsqueda«, ya no es posible eliminar elementos de la lista de motores de búsqueda predeterminados (Google, Bing, Yahoo).
El cambio entró en vigor con el lanzamiento de Chromium 97 y también afectó a todos los navegadores basados en él, incluidos los nuevos lanzamientos de Microsoft Edge, Opera y Brave (Vivaldi permanece en el motor Chromium 96 por ahora).
Además de ocultar el botón de eliminar en el navegador, también se menciona que se limita la capacidad de editar los parámetros del motor de búsqueda, lo que ahora permite al usuario poder cambiar solo el nombre y las palabras clave, pero bloquea el cambio de la URL con los parámetros de consulta. Al mismo tiempo, se conserva la función de eliminar y editar motores de búsqueda adicionales agregados por el usuario.
Varias personas se quejan en los foros de ayuda de que ya no pueden eliminar Yahoo! y otros motores de búsqueda de la lista. Esto parece un poco duro He visto más publicaciones sobre «No puedo eliminar motores de búsqueda» que publicaciones sobre «Acabo de eliminar el motor de búsqueda de Google de la lista» en los últimos 6 meses.
¿Quién decide cuáles son los motores de búsqueda que no podemos eliminar?
Se menciona que el principal motivo de la prohibición de eliminar y cambiar la configuración predeterminada del motor de búsqueda es debido a que se ha observado que es difícil para una gran cantidad de usuario el poder restaurar la configuración después de una eliminación imprudente: el motor de búsqueda predeterminado se puede eliminar con un solo clic, después de lo cual el trabajo de los consejos contextuales, se interrumpe una página de nueva pestaña y otras funciones relacionadas con el acceso a los motores de búsqueda.
Ademas de que para ello, al mismo tiempo, para restaurar registros eliminados, no es suficiente usar el botón para agregar un motor de búsqueda personalizado, sino una operación que requiere mucho tiempo para que un usuario común transfiera la configuración inicial del archivo de instalación, lo que requiere editar archivos de perfil, se requiere.
Algunas personas utilizan la eliminación como una solución alternativa para bloquear cambia el motor de búsqueda predeterminado, por lo que debemos continuar apoyarlo por ahora.
Esta es una reversión parcial … Este cambio lo hace para que pueda eliminar los motores de búsqueda rellenados previamente de nuevo, pero evita que el interruptor del cambio anterior deshabilite la opción de eliminación para motores de búsqueda que no admiten la eliminación para ocultar la eliminación opción. Esto es consistente con otros cambios recientes en la búsqueda página de configuración del motor donde hemos estado ocultando opciones no admitidas porque hay un conjunto más amplio de acciones potenciales en los motores de búsqueda.
Los desarrolladores consideraron agregar una advertencia sobre las posibles consecuencias de la eliminación, pero también podrían implementar un cuadro de diálogo para agregar un motor de búsqueda predeterminado o restaurar la configuración original, pero al final se decidió simplemente deshabilitar el botón de eliminar entradas.
La función de eliminación predeterminada del motor de búsqueda podría ser útil para deshabilitar por completo el acceso a sitios externos al escribir en la barra de direcciones, o para bloquear los cambios realizados en la configuración del motor de búsqueda por complementos maliciosos, por ejemplo, al intentar redirigir consultas clave en la barra de direcciones a su propio sitio.
Finalmente, cabe mencionar que uno de los desarrolladores de Chromium que implementó la prohibición de eliminar los motores de búsqueda predeterminados ha dicho que planea recuperar la funcionalidad de eliminación en una de las próximas versiones de Chromium (98 o 99), cuyo lanzamiento está programado para fines de febrero. – principios de marzo de 2022.
Son muchas las tareas que la inteligencia artificial puede realizar mejor que las personas, relativamente a un costo mínimo.
Este simple hecho está a punto de generar un tremendo impacto económico, pero también de causar un desplazamiento laboral sin precedentes, una ola de disrupción que afectará a los trabajadores de cuello azul y blanco por igual.
La IA hará de todo en el futuro, desde respaldar nuestros préstamos hasta construir nuestras casas, e incluso contratarnos y despedirnos. Este cambio de la forma en que se realiza el trabajo no solo dará como resultado un desempleo severo, sino que potencialmente desencadenará una serie de problemas sociales, que incluyen depresión, suicidio, abuso de sustancias, desigualdad cada vez mayor y malestar social.
Con todo eso, ¿dónde nos deja la tecnología? ¿Cuáles son los trabajos que la IA puede y no puede desplazar? ¿Cuál es el futuro del trabajo?
Los trabajos con mayor riesgo de automatización por IA tienden a ser trabajos de rutina y de nivel de entrada. La principal ventaja de la IA sobre los humanos radica en su capacidad para detectar patrones increíblemente sutiles dentro de grandes cantidades de datos.
Por ejemplo, en el caso de las solicitudes de préstamos. Mientras que un avalista humano observará solo un puñado de medidas al decidir si aprueba tu solicitud de crédito (tu patrimonio neto, ingresos, casa, trabajo, etc.), un algoritmo de IA tomará en cuenta miles de variables, que van desde registros públicos, extractos bancarios, tus compras, tus registros de atención médica y qué aplicaciones y dispositivos usas (con tu consentimiento), en milisegundos, para obtener una evaluación mucho más precisa de tu solicitud.
Ese tipo de algoritmos desplazarán fácilmente el trabajo rutinario de cuello blanco.
Cuando se combina con la robótica, la IA también desplazará tipos cada vez más complejos de trabajo manual. Para 2041, los preparadores de pedidos (picker, en inglés), que realizan tareas de rutina, habrán sido desplazados.
Concepto futurista robótico inteligente en agricultura.
Lo mismo ocurrirá con muchos trabajadores de la construcción. Prescindirán de ellos a medida que las prácticas en esta industria cambien hacia componentes prefabricados construidos por robots que son fáciles de ensamblar en masa.
3 cosas que la inteligencia artificial no puede hacer
Estas son las tres capacidades en las que se estima que la IA se está quedando corta, y que probablemente aún tendrá dificultades para dominar incluso en 2041:
1. Creatividad
La IA no puede crear, conceptualizar o planificar estratégicamente. Si bien la IA es excelente para optimizar para un objetivo limitado, no puede elegir sus propios objetivos o pensar de manera creativa.
La IA tampoco puede pensar en todos los dominios ni aplicar el sentido común.
2. Empatía
La IA no puede sentir ni interactuar con sentimientos como la empatía y la compasión. Por lo tanto, la IA no puede hacer que otra persona se sienta comprendida y protegida.
Incluso si la IA mejora en esta área, será extremadamente difícil llevar la tecnología a un lugar donde los humanos se sientan cómodos interactuando con robots en situaciones que requieren atención y empatía, o lo que podríamos llamar «servicios de contacto humano».
3. Destreza
La IA y la robótica no pueden realizar un trabajo físico complejo que requiera destreza o una coordinación ojo-mano precisa. La inteligencia artificial no puede lidiar con espacios desconocidos y no estructurados, especialmente aquellos que no ha observado.
¿Qué significa todo esto para el futuro de los puestos de trabajo?
Es probable que los trabajos que son asociales y rutinarios, como el telemercadeo o el corretaje de seguros, sean asumidos en su totalidad por la IA.
Para trabajos que son altamente sociales pero rutinarios, los humanos y la IA trabajarían juntos, cada uno aportando experiencia.
Por ejemplo, en el futuro salón de clases, la IA podría encargarse de calificar tareas y exámenes de rutina, e incluso ofrecer lecciones estandarizadas y ejercicios individualizados, mientras que el maestro humano se enfocaría en ser un mentor empático que aplica el aprendizaje práctico, supervisa proyectos grupales que desarrollan inteligencia emocional y brinda coaching personalizado.
Concepto futurista de la industria de la educación inteligente.
Para los trabajos que son creativos pero asociales, la creatividad humana se verá amplificada por las herramientas de la IA. Por ejemplo, un científico puede usar herramientas de inteligencia artificial para acelerar la velocidad en el descubrimiento de fármacos.
Finalmente, los trabajos que requieren tanto creatividad como habilidades sociales, como los roles ejecutivos con mucha estrategia, son aquellos en los que los humanos brillarán.
Si bien está claro que hay muchas líneas de trabajo en las que la IA tendrá dificultades para dominar, y por lo tanto sería más seguro que los trabajadores las siguieran para sus carreras, estas por sí solas no evitarán un desastre para las legiones de trabajadores desplazados de roles que serán más fáciles de dominar por la IA.
Entonces, ¿qué más podemos hacer para ayudar a cumplir el deseo humano básico de tener un sustento significativo?
Volver a aprender, recalibrar y renacer
Para crear más puestos de trabajo y mejorar la preparación de los trabajadores para la transformación que se vislumbra en el horizonte, el científico informático taiwanés Kai-Fu Lee y el escritor de ciencia ficción chino Chen Qiufan proponen en un artículo para BIGTHINK las 3 R: reaprender, recalibrar y renacer.
Según su artículo, esta propuesta forma parte de un esfuerzo gigantesco para abordar el tema central de nuestro tiempo: la revolución económica de la IA.
Los autores destacan además que es necesario advertir a las personas en trabajos en peligro con suficiente anticipación y alentarlas a aprender nuevas habilidades.
La buena noticia es que, como se mencionó, hay habilidades que la IA no puede dominar: estrategia, creatividad, habilidades sociales basadas en la empatía y destreza. Además, las nuevas herramientas de IA requerirán operadores humanos.
Así entonces. podemos ayudar a las personas a adquirir estas nuevas habilidades y prepararse para este nuevo mundo laboral.
Las escuelas vocacionales necesitan rediseñar sus planes de estudios para promover cursos para tales trabajos sostenibles. Los gobiernos podrían tomar la iniciativa y proporcionar incentivos y subsidios para estos cursos, en lugar de seguir ciegamente medidas económicas generales, como el ingreso básico universal.
Con pandemia o sin ella, la importancia y la cantidad de trabajos de servicios centrados en el ser humano, como la enfermería, también aumentarán a medida que aumenten la riqueza y la esperanza de vida.
La sociedad ha devaluado constantemente roles de servicio tan vitales centrados en el ser humano, tanto en términos de cómo se perciben como de cuánto se les compensa, y debemos abordar este descuido.
Concepto de la futura interacción con la inteligencia artificial.
Además de volver a aprender habilidades, necesitamos recalibrar cómo se ven los trabajos de hoy con la ayuda de la IA, avanzando hacia una simbiosis humano-IA.
Las simbiosis más frecuentes y básicas se encontrarán en las herramientas de software de IA. El software impulsa una interdependencia humano-PC, que ya ha revolucionado el trabajo de oficina.
Las herramientas de software de inteligencia artificial pueden idear alternativas, optimizar resultados o realizar trabajos de rutina para profesionales administrativos en muchos campos.
Las herramientas específicas de IA se personalizarán para cada profesión y aplicación, por ejemplo, generación de moléculas basadas en IA para productos farmacéuticos, planificación publicitaria para marketing o verificación de hechos para periodismo.
Una interdependencia más profunda entre las optimizaciones de IA y el «toque humano» reinventará muchos trabajos y creará otros nuevos.
La IA se encargará de las tareas rutinarias junto con los humanos, quienes llevarán a cabo las que requieran calidez y compasión.
Por ejemplo, el futuro médico seguirá siendo el principal punto de contacto de confianza del paciente, pero dependerá de las herramientas de diagnóstico de IA para determinar el mejor tratamiento. Esto redirigirá el papel del médico al de un cuidador compasivo, brindándole más tiempo con sus pacientes.
Así como el internet móvil dio lugar a puestos de trabajo como el de conductor de Uber, la llegada de la IA creará puestos de trabajo que ni siquiera podemos concebir todavía.
Los ejemplos actuales incluyen ingenieros de inteligencia artificial, científicos de datos, etiquetadores de datos y mecánicos de robots. Pero aún no sabemos y no podemos predecir muchas de estas nuevas profesiones, al igual que en 2001 no podíamos saber acerca de los conductores de Uber.
Debemos estar atentos al surgimiento de los nuevos roles, concientizar a las personas sobre ellos y brindarles capacitación.
Finalmente, con la capacitación adecuada y las herramientas adecuadas, podemos esperar un renacimiento liderado por la IA que habilitará y celebrará la creatividad, la compasión y la humanidad.
Desde el siglo XIV hasta el XVII, las ricas ciudades y comerciantes de Italia financiaron el Renacimiento, que vio un florecimiento de la producción artística y científica.
Tenemos motivos para anticipar que la IA será el catalizador de un nuevo renacimiento centrado en la expresión y la creatividad humana. Al igual que con el Renacimiento italiano, las personas seguirán sus pasiones, creatividad y talentos una vez que tengan más libertad y tiempo.
Pintores, escultores y fotógrafos utilizarán herramientas de IA para componer, experimentar y refinar obras de arte. Novelistas, periodistas y poetas utilizarán las nuevas tecnologías para la investigación y la composición. Los científicos utilizarán herramientas de IA para acelerar el descubrimiento de fármacos.
Un renacimiento de la IA reinventará la educación, brindando a los maestros herramientas de IA para ayudar a cada estudiante a encontrar sus propias pasiones y talentos. La educación fomentará la curiosidad, el pensamiento crítico y la creatividad. Promoverá el aprendizaje práctico y actividades grupales que mejoren la inteligencia emocional de los estudiantes, y que los ponga cara a cara entre sí, y no solo frente a una pantalla.
Un nuevo contrato social
Para los expertos Kai-Fu Lee y Chen Qiufan, convertir algunas de las ideas anteriores en realidad sería un compromiso sin precedentes para la humanidad.
¿Qué necesitamos?
Volver a capacitar a una gran cantidad de trabajadores desplazados.
Recaudar una cantidad astronómica de dinero para financiar esta transición.
Reinventar la educación para producir graduados creativos, sociales y multidisciplinarios. Necesitamos redefinir la ética de trabajo de la sociedad, los derechos de los ciudadanos, las responsabilidades de las corporaciones y el papel de los gobiernos.
Por suerte, no necesitamos crear esto desde cero. Muchos elementos ya existen en diferentes países. Tomemos, por ejemplo, los programas educativos para «superdotados y talentosos» en Corea, la educación primaria en Escandinavia, las innovaciones universitarias (como los cursos masivos abiertos en línea, o MOOC, y Minerva Schools) en los Estados Unidos, la cultura de la artesanía en Suiza, el servicio excelencia en Japón, la vibrante tradición del voluntariado en Canadá, el cuidado de los ancianos en China y la “felicidad nacional bruta” de Bután.
Concepto de inteligencia humana vs artificial.
Necesitamos compartir nuestras experiencias y trazar un camino a seguir a nivel mundial, donde las nuevas tecnologías se equilibren con las nuevas instituciones socioeconómicas.
¿Dónde encontraremos el coraje y la audacia para asumir esta gigantesca tarea?
Somos la generación que heredará la riqueza sin precedentes de la inteligencia artificial, por lo que también debemos asumir la responsabilidad de reescribir el contrato social y reorientar nuestras economías para promover el florecimiento humano.
Y si eso no es suficiente, pensemos en nuestra posteridad: la IA nos liberará del trabajo rutinario, nos dará la oportunidad de seguir nuestros corazones y nos empujará a pensar más profundamente sobre lo que realmente nos hace humanos.
Hace poco se dio a conocer la noticia de que fue identificada una vulnerabilidad (ya catalogada bajo CVE-2021-4122) en el paquete Cryptsetup, que se utiliza para cifrar particiones de disco en Linux.
Se menciona que para aprovechar la vulnerabilidad, un atacante debe tener acceso físico al medio cifrado, es decir, el método tiene sentido principalmente para atacar unidades externas cifradas, como unidades flash, a las que el atacante tiene acceso, pero no conoce la contraseña para descifrar los datos.
El ataque es aplicable solo para el formato LUKS2 y está asociado con la manipulación de metadatos responsable de activar la extensión «online reencryption», que permite, si es necesario, cambiar la clave de acceso, iniciar el proceso de recifrado de datos sobre la marcha sin detener el trabajo con la partición.
Dado que el proceso de descifrado y cifrado con una nueva clave lleva mucho tiempo, el «online reencryption»» permite no interrumpir el trabajo con la partición y realizar el reencriptado en segundo plano, transfiriendo gradualmente los datos de una clave a otra. En particular, es posible seleccionar una clave de destino vacía, lo que le permite traducir la sección a un formulario descifrado.
Un atacante puede realizar cambios en los metadatos de LUKS2 que simulan un aborto de la operación de descifrado como resultado de una falla y lograr el descifrado de parte de la partición después de la posterior activación y uso de la unidad modificada por parte del propietario. En este caso, el usuario que conectó la unidad modificada y la desbloqueó con la contraseña correcta no recibe ninguna advertencia sobre la restauración de la operación de recifrado interrumpida y puede conocer el progreso de esta operación solo con el comando «luks Dump». La cantidad de datos que un atacante puede descifrar depende del tamaño del encabezado LUKS2, pero con el tamaño predeterminado (16 MiB) puede superar los 3 GB.
El problema se origina por el hecho de que a pesar de que la operación de recifrado requiere el cálculo y verificación de los hash de las claves nuevas y antiguas, no se requiere el hash para restaurar el proceso de descifrado interrumpido si el nuevo estado implica la ausencia de una clave para el cifrado (texto plano).
Además, los metadatos de LUKS2 que especifican el algoritmo de cifrado no están protegidos contra modificaciones si caen en manos de un atacante. Para bloquear la vulnerabilidad, los desarrolladores agregaron protección de metadatos adicional a LUKS2, para lo cual ahora se verifica un hash adicional, calculado en base a claves conocidas y contenido de metadatos, es decir, un atacante ya no podrá cambiar sigilosamente los metadatos sin conocer la contraseña de descifrado.
Un escenario de ataque típico requiere que el atacante tenga la oportunidad de poner sus manos en el disco varias veces. Primero, el atacante, que no conoce la contraseña de acceso, realiza cambios en el área de metadatos que inician el descifrado de parte de los datos la próxima vez que se active la unidad.
Luego, la unidad se devuelve a su lugar y el atacante espera hasta que el usuario la conecta ingresando una contraseña. Durante la activación del dispositivo por parte del usuario, se inicia un proceso de recifrado en segundo plano, durante el cual parte de los datos cifrados se reemplazan con datos descifrados. Además, si un atacante puede volver a poner sus manos en el dispositivo, algunos de los datos en el disco estarán descifrados.
El problema fue identificado por el mantenedor del proyecto cryptsetup y solucionado en las actualizaciones cryptsetup 2.4.3 y 2.3.7.
El estado de generación de actualizaciones con la solución del problema en las distribuciones se puede rastrear en estas páginas: RHEL, SUSE, Fedora, Ubuntu, Arch. La vulnerabilidad aparece solo desde el lanzamiento de cryptsetup 2.2.0, que introdujo soporte para la operación de «recifrado en línea». Comenzar con la opción «–disable-luks2-reencryption» se puede usar como una solución de seguridad.
Finalmente si estás interesado en conocer más al respecto sobre la noticia, puedes consultar los detalles en el siguiente enlace.
Hace pocos dias investigadores de la Universidad de Waterloo y el Laboratorio de Investigación Naval de EE. UU. presentaron los resultados del desarrollo de un simulador de red Tor que es comparable en número de nodos y usuarios a la red Tor principal y permite experimentos que se acercan a las condiciones reales.
El toolkit y la metodología de modelado de red elaborados durante el experimento permitieron simular el funcionamiento de una red de 6489 nodos Tor en una computadora con 4 TB de RAM, a la que están conectados simultáneamente 792 mil usuarios virtuales.
Cabe señalar que esta es la primera simulación a gran escala de la red Tor, cuyo número de nodos corresponde a la red real (la red Tor en funcionamiento tiene alrededor de 6 mil nodos y 2 millones de usuarios conectados ).
Una simulación completa de la red Tor es de interés en términos de identificación de cuellos de botella, modelado del comportamiento de ataque, prueba de nuevas técnicas de optimización en condiciones de la vida real y prueba de conceptos relacionados con la seguridad.
Con un simulador completo, los desarrolladores de Tor podrán alejarse de la práctica de realizar experimentos en la red principal o en nodos de trabajo individuales, lo que crea riesgos adicionales de violar la privacidad del usuario y no eliminar la posibilidad de fallas. Por ejemplo, en los próximos meses, se espera que Tor introduzca soporte para un nuevo protocolo de control de congestión, y la simulación le permitirá estudiar completamente su funcionamiento antes de implementarlo en una red real.
Además de eliminar el impacto de los experimentos en la confidencialidad y confiabilidad de la red Tor principal, la presencia de redes de prueba separadas hará posible probar y depurar rápidamente código nuevo durante el desarrollo, implementar cambios de inmediato para todos los nodos y usuarios sin esperar la finalización de implementaciones intermedias largas, crear y ejecutar prototipos más rápidamente con la implementación de nuevas ideas.
Se trabaja en la mejora del toolkit que, según afirman los desarrolladores, reducirá 10 veces el consumo de recursos y permitirá simular en un mismo equipo el funcionamiento de redes que superan la red real, lo que puede ser necesario para identificar posibles problemas. con escalado Tor. En el transcurso del trabajo, también se han creado varios métodos nuevos de modelado de red que permiten predecir el cambio en el estado de la red a lo largo del tiempo y usar generadores de tráfico de fondo para simular la actividad del usuario.
Los investigadores también estudiaron el patrón entre el tamaño de la red simulada y la confiabilidad de proyectar los resultados de los experimentos en la red real. Durante el desarrollo de Tor, los cambios y las optimizaciones se prueban previamente en pequeñas redes de prueba, que contienen significativamente menos nodos y usuarios que una red real.
Se encontró que los errores estadísticos de los pronósticos obtenidos durante simulaciones pequeñas pueden compensarse mediante la repetición repetida de experimentos independientes con diferentes conjuntos de datos iniciales, mientras que cuanto más grande es la red simulada, se requieren menos reensayos para obtener conclusiones estadísticamente significativas.
Para modelar y simular la red Tor, los investigadores están desarrollando varios proyectos de código abierto distribuidos bajo la licencia BSD:
Shadow: un simulador de red universal que le permite ejecutar código de aplicación de red real para recrear el funcionamiento de sistemas distribuidos con miles de procesos de red. Para simular sistemas basados en aplicaciones reales no modificadas.
Tornettools: un conjunto de herramientas para generar modelos realistas de la red Tor que se pueden ejecutar en el entorno Shadow, así como para ejecutar y personalizar el proceso de simulación, acumulando y visualizando los resultados. Las métricas que reflejan el rendimiento de la red Tor real se pueden usar como plantillas para la generación de redes.
TGen: generador de flujos de tráfico en función de los parámetros establecidos por el usuario (tamaño, retrasos, número de flujos, etc.). Los esquemas de modelado de tráfico se pueden establecer sobre la base de escenarios especiales en el formato GraphML y utilizando modelos probabilísticos de Markov para la distribución de flujos y paquetes TCP.
OnionTrace: un conjunto de herramientas para monitorear el desempeño y los eventos en una red Tor simulada, así como para registrar y reproducir información sobre la formación de cadenas de nodos Tor y vincular flujos de tráfico a ellos.
Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.
2FA sobre Linux: ¿Cómo instalar Google Authenticator y Twilio Authy?
El tutorial de hoy, está íntimamente relacionado con el tema de la Seguridad informática o Ciberseguridad. Ya que, como muchos saben, gestionar el acceso a nuestros recursos en línea mediante solo contraseñas ya no se considera nada seguro. Por ende, lo más recomendable es el uso de alternativas complementarias, entre las cuales una de las más conocidas es la tecnología «2FA».
La tecnología «2FA», mejor conocida en español como «Doble Factor de Autenticación» o «Autenticación de dos factores», es un excelente método de protección, ya que, implementa una capa de validación más en nuestras actividades. Y para usar esta tecnología, existen muchas apps tales Google Authenticator y Twilio Authy. Las cuales, aquí veremos como instalarlas sobre GNU/Linux.
Y como de costumbre, antes de entrar de lleno en el punto de hoy sobre la tecnología «2FA» y sobre instalar Google Authenticator y Twilio Authy en GNU/Linux, dejaremos para aquellos interesados en explorar algunas anteriores publicaciones relacionadas con lo aquí abordado, los siguientes enlaces a las mismas. Para que puedan explorarlas fácilmente, en caso de ser necesario, luego de finalizar de leer esta presente publicación:
“El movimiento para habilitar automáticamente la autenticación de dos factores tiene como objetivo aumentar la seguridad de las cuentas de usuario de Google al eliminar la «amenaza más importante» que facilita el hackeo: las contraseñas que son difíciles de recordar y, lo que es peor, fáciles de robar. Según Mark Risher, una de las mejores formas de proteger una cuenta contra una contraseña incorrecta o descifrada es configurar una segunda forma de verificación, otra forma para que su cuenta confirme que es realmente su conexión»”.Google habilitará la autenticación de dos factores de forma predeterminada para todos
2FA: Doble Factor de Autenticación
¿Qué es 2FA?
La tecnología «2FA» sirve para lograr que una persona o usuario, deba y pueda, autenticarse en una cuenta de usuario mediante un paso adicional más, es decir, en dos pasos en vez de uno.
Lo que en la práctica deja como resultado, el tener que introducir un código o contraseña posterior al proceso tradicional de escribir el nombre de usuario o correo y la contraseña asociada. Que es por lo general, el único paso que solemos necesitar de modo predeterminado para entrar en una cuenta de un servicio, recurso o aplicación.
Por ende, dicho mecanismo o tecnología se esfuerza en lograr confirmar que realmente eres tú el usuario real y válido, quien está accediendo a la cuenta de usuario del correspondiente servicio, recurso o aplicación.
Esto suele ser de suma importancia, ya que, principalmente y de modo regular se realizan hackeos (actos de piratería digital) con sus respectivas filtraciones de datos que incluyen cuentas, nombres y contraseñas de usuarios, de múltiples proveedores o dueños de servicios, recursos y aplicaciones en línea.
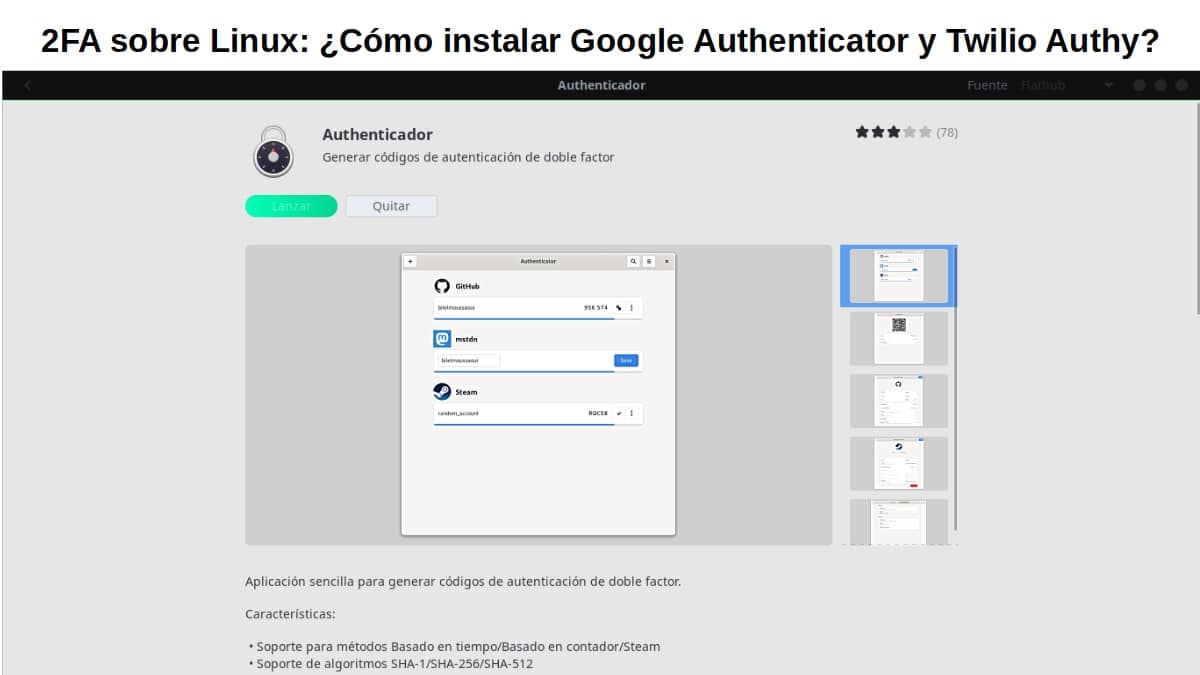
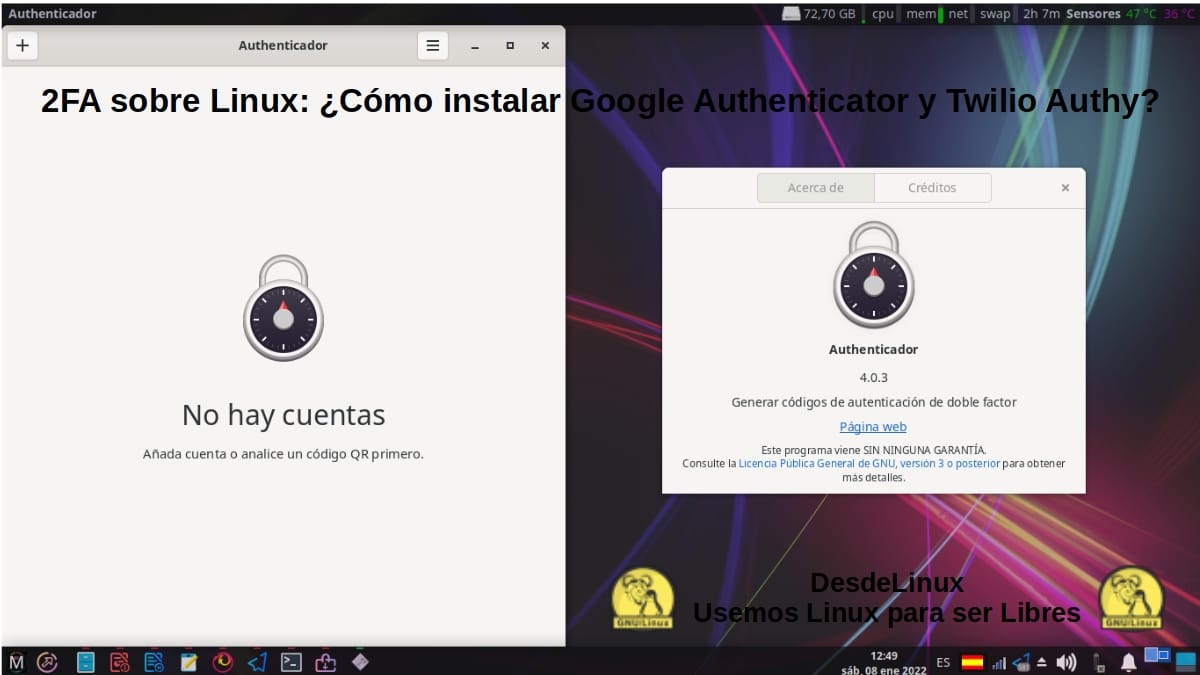
Por último, para emplear la tecnología «2FA», se pueden utilizar muchas apps disponibles, pero 2 aplicaciones famosas en este ámbito, que son Google Authenticator y Twilio Auth. Las cuales a continuación, aprenderemos a instalar fácilmente sobre nuestros Sistemas Operativos GNU/Linux mediante la aplicación gráfica llamada Software de GNOME.
¿Cómo instalar Google Authenticator sobre Linux?
Para instalar Google Authenticator sobre GNU/Linux necesitamos asegurarnos de tener instalado el soporte para gestionar la paquetería Snap, ejecutando los siguientes pasos en un Terminal (Consola):
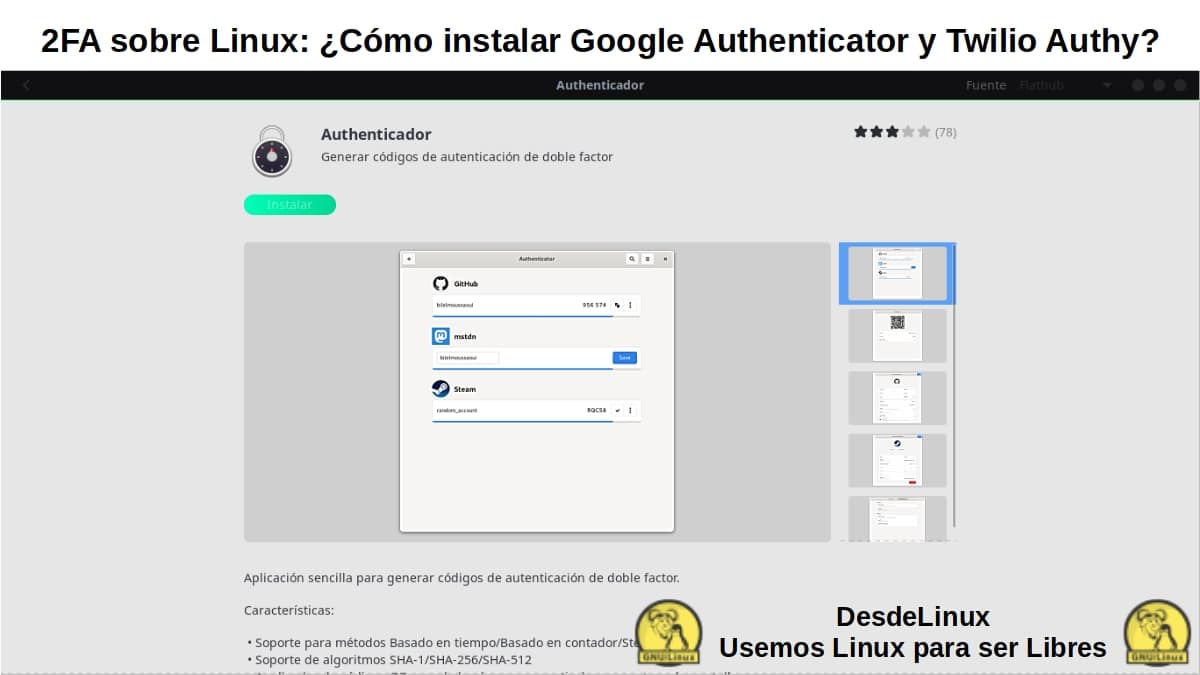
Luego, reiniciamos el Sistema Operativo y ya podemos abrir la aplicación Software de GNOME, buscarla e instalarla, tal como se muestra en la siguiente imagen:
“La Tecnología «2FA» se conoce en inglés como «Two Factor Authentication» y en español como «Doble Factor de Autenticación» o «Autenticación de dos factores». Y en algunos casos, como: Verificación en dos pasos (2-Step Verification – 2SV)”.
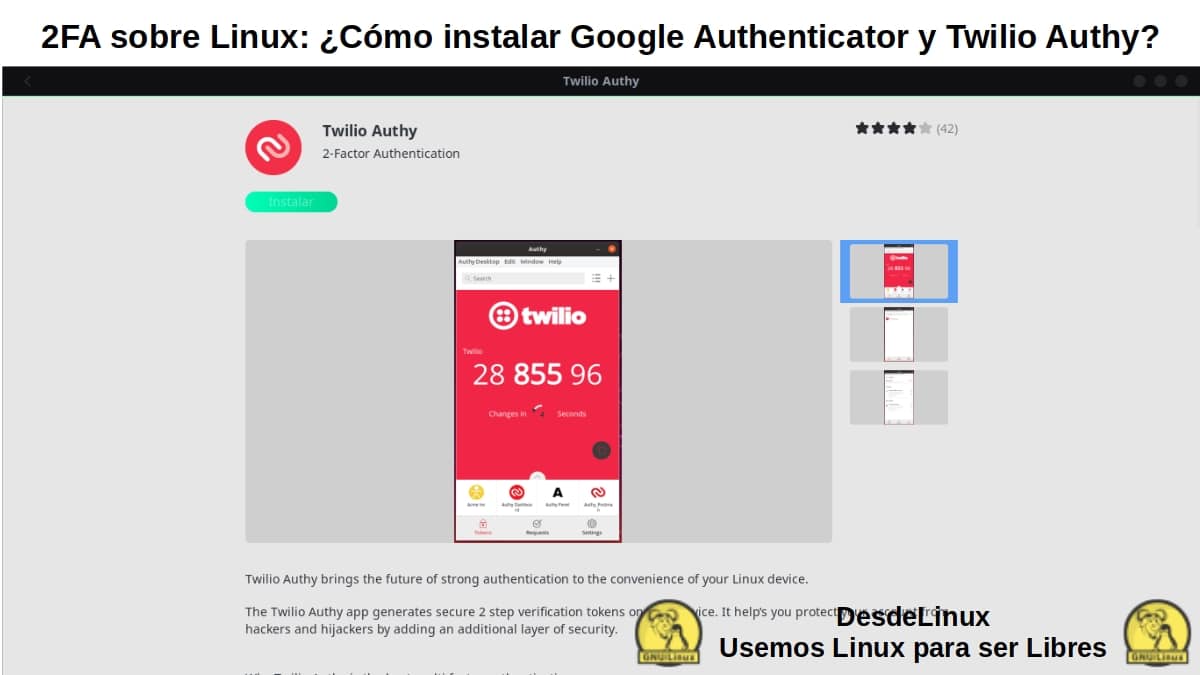
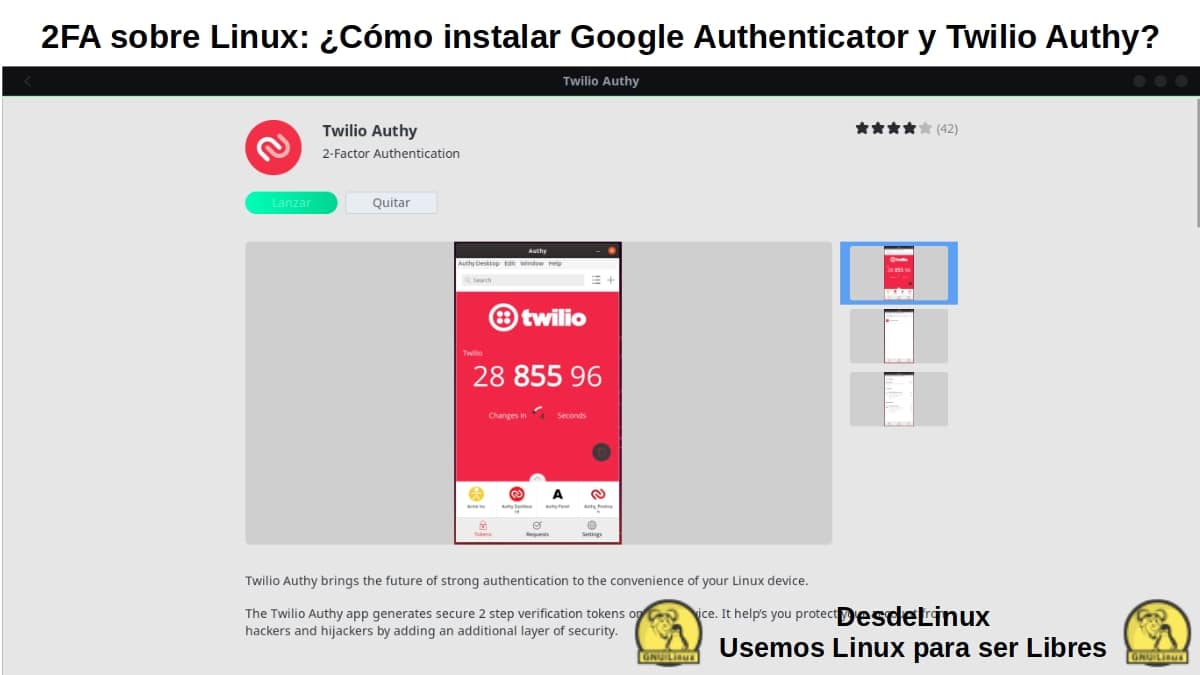
¿Cómo instalar Twilio Authy sobre Linux?
Para instalar Twilio Authy sobre GNU/Linux necesitamos asegurarnos de tener instalado el soporte para gestionar la paquetería Flatpak, ejecutando los siguientes pasos en un Terminal (Consola):
Luego, reiniciamos el Sistema Operativo y ya podemos abrir la aplicación Software de GNOME, buscarla e instalarla, tal como se muestra en la siguiente imagen:
“Con la activación de la Tecnología «2FA» se puede lograr obtener una manera de confirmar que quien está intentando autenticarse es el usuario real y válido (nosotros), de una manera fácil y eficiente. Para así, mitigar o evitar vernos afectados en cualquier momento sin darnos cuenta, de los ataques de terceros mediante el uso de nuestros datos con intenciones peligrosas y dañinas”.
Resumen
En resumen, la Tecnología «2FA» es una genial y sencilla tecnología que bien implementada ofrece una confiable y segura capa adicional de seguridad contra los procesos de usurpación de identidades y accesos indebidos de cuentas por parte de terceros. Por ende, usarla evitará a cualquiera muchos problemas diversos derivados de consecuencias futuras de violaciones de seguridad. Y para ello, como se puede constatar podemos utilizar sobre GNU/Linux tanto Google Authenticator y Twilio Authy, sin mayores dificultades.
Esperamos que esta publicación, sea de mucha utilidad para toda la «Comunidad de Software Libre, Código Abierto y GNU/Linux». Y no dejes de comentarla más abajo, y de compartirla con otros en tus sitios webs, canales, grupos o comunidades favoritas de redes sociales o sistemas de mensajería. Por último, visita nuestra página de inicio en «DesdeLinux» para explorar más noticias, y únete a nuestro canal oficial de Telegram de DesdeLinux.