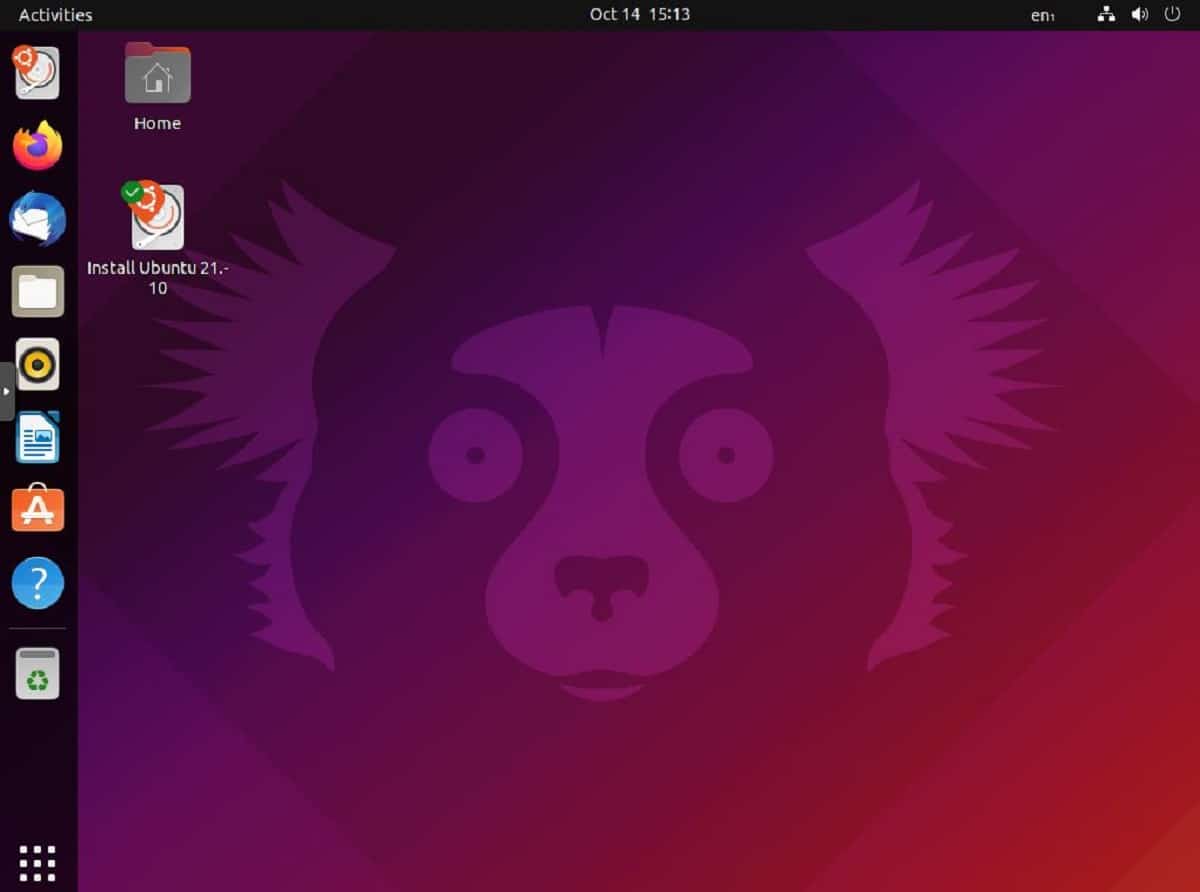
Ubuntu 21.10 «Impish Indri» llega con actualizaciones, nuevo instalador y mas

La nueva versión de Ubuntu 21.10 «Impish Indri» ya fue liberada después de varios meses des desarrollo y pocos dias de la congelación que sirvió para las pruebas finales y la corrección de errores.

En esta nueva versión de la distribución se ha realizado la transición al uso de GTK4 y al escritorio GNOME 40, en el que se ha modernizado significativamente la interfaz. Los escritorios virtuales de Descripción general de actividades están configurados en orientación horizontal y se muestran en un bucle continuo de izquierda a derecha.

En cada escritorio que se muestra en el modo de vista general muestra claramente las ventanas disponibles, que se desplazan y escalan dinámicamente mediante la interacción del usuario. Se proporciona una transición perfecta entre la lista de programas y los escritorios virtuales. Mejor organización del trabajo con múltiples monitores. GNOME Shell proporciona una GPU para renderizar sombreadores.

Otro de los cambios es la nueva versión completamente ligera de Yaru utilizada en Ubuntu, junto con la cual también se proporciona una opción completamente oscura (encabezados oscuros, fondos oscuros y controles oscuros). El soporte para el antiguo tema combinado (encabezados oscuros, fondo claro y controles claros) se ha descontinuado debido a la falta de capacidad de GTK4 para definir diferentes colores de fondo y texto para el título y la ventana principal, lo que no garantiza que todas las aplicaciones GTK funcionen correctamente cuando se utiliza el tema combinado.

En la parte de la instalación, podremos encontrar el nuevo instalador para Ubuntu Desktop que se ha propuesto implementado en forma de un complemento sobre el instalador de bajo nivel Curtin, que ya se utiliza en el instalador Subiquity defecto en Ubuntu Server. El nuevo instalador para Ubuntu Desktop está escrito en Dart y usa el marco Flutterpara construir una interfaz de usuario.

El nuevo instalador se ha diseñado teniendo en cuenta el escritorio moderno de Ubuntu y está diseñado para proporcionar un proceso de instalación coherente en toda la línea de productos de Ubuntu. Se ofrecen tres modos: «Instalación de reparación» para reinstalar todos los paquetes disponibles en el sistema sin cambiar la configuración, «Probar Ubuntu» para familiarizarse con el kit de distribución en modo Live e «Instalar Ubuntu» para instalar el kit de distribución en el disco.

Otra de las novedades que se destaca es que se proporcionó la capacidad de usar una sesión de escritorio basada en el protocolo Wayland en entornos con controladores de NVIDIA.

Mientras que por la parte del sonido en PulseAudio se ha ampliado significativamente el soporte para Bluetooth, pues en esta nueva version se agregaron los códecs A2DP LDAC y AptX, soporte integrado para el perfil HFP (Hands-Free Profile), lo que hizo posible mejorar la calidad del sonido.

También hubo cambos en el manejo de los paquetes, pues se realizaron algunos cambiamos a usar el algoritmo zstd para comprimir paquetes deb, que casi duplicará la velocidad de instalación de paquetes, a costa de un pequeño aumento en su tamaño (~ 6%). El soporte para usar zstd ha estado presente en apt y dpkg desde Ubuntu 18.04, pero no se ha usado para comprimir paquetes.

De los demás cambios que se destacan de esta nueva versión:

  • De forma predeterminada, el filtro de paquetes nftables está habilitado: Para mantener la compatibilidad con versiones anteriores, está disponible el paquete iptables-nft, que proporciona utilidades con la misma sintaxis de línea de comando que en iptables, pero traduce las reglas resultantes al código de bytes nf_tables.
  • Se ha utilizado el kernel de Linux 5.13
  • Versiones actualizadas de programas, incluidos PulseAudio 15.0, BlueZ 5.60, NetworkManager 1.32.10, LibreOffice 7.2.1, Firefox 92 y Thunderbird 91.1.1.
  • El navegador Firefox se ha transferido de forma predeterminada a la entrega en forma de paquete instantáneo, acompañado por empleados de Mozilla (se conserva la capacidad de instalar un paquete deb, pero ahora es una opción).

Finalmente si estás interesado en conocer más al respecto, puedes consultar los detalles en el siguiente enlace.

Descargar Ubuntu 21.10 «Impish Indri»

Para quienes estén interesados en poder obtener esta nueva versión del sistema, pueden obtener la imagen ISO desde el siguiente enlace.


from Desde Linux https://ift.tt/3lCHNtn
via IFTTT
La Fundación Linux recibirá una financiación de $10 millones de la OpenSSF para la mejora de la seguridad del open source

Fundación Linux - CES 2020: Introducción

Hace poco la Fundación Linux dio a conocer mediante una publicación de blog el compromiso por parte de la OpenSSF (Open Source Security Foundation) de financiar a la Fundación Linux con $10 millones de dólares, esto como parte de un esfuerzo para mejorar la seguridad del software de código abierto.

Se mencionan que los fondos recaudados son a través de regalías de empresas matrices de OpenSSF, incluidas Amazon, Cisco, Dell Technologies, Ericsson, Facebook, Fidelity, GitHub, Google, IBM, Intel, JPMorgan Chase, Microsoft, Morgan Stanley, Oracle, Red Hat, Snyk y VMware.

«Este compromiso de toda la industria responde al llamado de la Casa Blanca para elevar la línea de base para nuestro bienestar colectivo de ciberseguridad, así como ‘pagar hacia adelante’ a las comunidades de código abierto para ayudarlas a crear software seguro del que todos nos beneficiamos», dijo Jim Zemlin, director ejecutivo de la Fundación Linux. “Nos complace contar con el liderazgo y la amplia experiencia de Brian Behlendorf en la construcción y el mantenimiento de grandes comunidades y proyectos técnicos aplicados a este trabajo. Con el tremendo crecimiento y la omnipresencia del software de código abierto, la creación de prácticas y programas de ciberseguridad que escalen es nuestra mayor tarea «.

Esta financiación es parte de una colaboración entre industrias que reúne múltiples iniciativas de software de código abierto bajo un mismo propósito para identificar y corregir vulnerabilidades de ciberseguridad en software de código abierto y desarrollar herramientas mejoradas, capacitación, investigación, mejores prácticas y prácticas de divulgación de vulnerabilidades.

Como recordatorio, el trabajo de OpenSSF se centra en áreas tales como divulgación coordinada de vulnerabilidades, distribución de parches, desarrollo de herramientas de seguridad, publicación de mejores prácticas para la organización de desarrollo seguro, identificación de amenazas relacionadas con la seguridad en software de código abierto, auditoría y Fortalecimiento del trabajo, proyectos de código abierto de misión crítica, creación de herramientas para verificar la identidad de los desarrolladores.

  • Security Scorecard: una herramienta totalmente automatizada que evalúa una serie de heurísticas importantes («comprobaciones») asociadas con la seguridad del software.
  • Best Practices Badge: un conjunto de mejores prácticas de la Iniciativa de infraestructura central para producir software seguro de mayor calidad que proporciona una forma para que los proyectos de OSS demuestren a través de insignias que los están siguiendo.
  • Security Policies: Allstar proporciona un conjunto y hace cumplir las políticas de seguridad en los repositorios u organizaciones.
  • Framework: los niveles de la cadena de suministro para artefactos de software (SLSA) ofrecen un marco de seguridad para aumentar los niveles de integridad de la cadena de suministro de software.
  • Capacitación: cursos gratuitos sobre fundamentos de desarrollo de software seguro que educan a los miembros de la comunidad sobre cómo desarrollar software seguro
  • Divulgaciones de vulnerabilidades: una guía para la divulgación coordinada de vulnerabilidades para proyectos de OSS
  • Análisis de paquetes: busqueda de software malicioso en paquetes OSS
  • Revisiones de seguridad: recopilación pública de revisiones de seguridad de OSS
  • Investigación: estudios sobre software de código abierto y vulnerabilidades de seguridad críticas realizados en asociación con el Laboratorio de Ciencias de la Innovación de Harvard (LISH) (por ejemplo, un censo preliminar y una Encuesta de Colaboradores de FOSS )

La OpenSSF continúa basándose en iniciativas como la Iniciativa de Infraestructura Central y la Coalición de Seguridad de Código Abierto y reúne otros trabajos relacionados con la seguridad que están realizando las empresas que se han unido al proyecto.

«Nunca ha habido un momento más emocionante para trabajar en la comunidad de código abierto, y la seguridad de la cadena de suministro de software nunca ha necesitado más de nuestra atención», dijo Brian Behlendorf, director general de Open Source Security Foundation. “No existe una fórmula mágica para asegurar las cadenas de suministro de software. La investigación, la capacitación, las mejores prácticas, las herramientas y la colaboración requieren el poder colectivo de miles de mentes críticas en toda nuestra comunidad. La financiación de OpenSSF nos brinda el foro y los recursos para realizar este trabajo «.

Finalmente si estás interesado en conocer más al respecto, puedes consultar la publicación original en el siguiente enlace.


from Desde Linux https://ift.tt/2YY4Iqt
via IFTTT

libmdbx 0.10.4 llega con diversas mejoras y correcciones de errores

Se dio a conocer la liberación de la versión 0.10.4 las bibliotecas «libmdbx» en la cual en total, se realizaron más de 160 cambios en 57 archivos, se agregaron ~ 5000 líneas y ~ 2500 se eliminaron. Para quienes desconocen de libmdbx, deben saber que este es un conjunto de bibliotecas las cuales son una  implementación de una base de datos integrada compacta de alto rendimiento de la clase de clave-valor.

Históricamente, libmdbx es una reelaboración profunda del DBMS de LMDB y supera a su predecesor en confiabilidad, conjunto de características y rendimiento. En comparación con LMDB, libmdbx pone mucho énfasis en la calidad del código, la estabilidad de la API, las pruebas y las comprobaciones automatizadas. Se proporciona una utilidad para verificar la integridad de la estructura de la base de datos con algunas opciones de recuperación.

Tecnológicamente, libmdbx ofrece ACID, serialización de cambios estrictos y lecturas sin bloqueo con escalado lineal en los núcleos de la CPU. Admite la compactación automática, el control automático del tamaño de la base de datos y la estimación de consultas de rango. Desde 2016, los proyectos han sido financiados por Positive Technologies y se han utilizado en sus productos desde 2017 .

Para libmdbx, se ofrece una API de C++, así como enlaces compatibles con los entusiastas de Rust, Haskell, Python, NodeJS, Ruby, Go, Nim. Para libfpta, solo la descripción de la API en forma de archivo de encabezado C / C ++ está disponible públicamente .

Además de que admite Linux, Windows, MacOS, Android, iOS, FreeBSD, DragonFly, Solaris, OpenSolaris, OpenIndiana, NetBSD, OpenBSD y otros sistemas compatibles con POSIX.1-2008 .

Principales novedades de libmdbx 0.10.4

En esta nueva versión de libmdbx 0.10.4 los desarrolladores trabajaron para poder proporcionar la capacidad de compilaciones reproducibles, además de que se han mejorado las pruebas y se han ampliado los scripts de prueba para comprobar todos los estados no isomórficos alcanzables del árbol de páginas y el contenido de GC dentro de la base de datos.

En la API de C++ corregida una vez «noexcept», se agregó la sobrecarga adicional para el método «cursor::erase()», la implementación de los búferes se alivia mediante el uso de «std::string» para garantizar la alineación (actual para CLANG libstdc ++)

Además, también se destaca que se llevó a cabo una verificación por fases con la adición de una serie de verificaciones para garantizar la estabilidad en caso de daño deliberado a la base de datos.

Por otra parte, se destaca que la búsqueda de los componentes del compilador necesarios para LTO (optimización del tiempo de enlace) se ha mejorado en los scripts de CMake, además de que el número máximo de lectores simultáneos se ha aumentado a 32.767 y tambien se ha mejorado el rendimiento al usar Valgrind y AddressSanitizer.

En cuanto a las correcciones de errores que se realizaron en esta nueva versión, se mencionan las siguientes:

  • Se corrigió un error por el cual, en muy raras circunstancias, se podía producir un bucle / bloqueo durante la confirmación de una transacción. El problema fue identificado por especialistas de Positive Technologies durante las pruebas internas de sus propios productos.
  • Se corrigió la regresión en el algoritmo de derrame de páginas sucias (desalojo selectivo de páginas de base de datos modificadas) que se manifestaba en un raro error inesperado MDBX_PROBLEM al cambiar datos en transacciones grandes.
  • Se corrigieron problemas menores de UndefinedBehaviorSanitizer y Coverity Scan.
    Se corrigió la comprobación de la bandera interna obsoleta y no utilizada «P_DIRTY» en las páginas anidadas dentro de las imágenes de la base de datos creadas por versiones antiguas de la biblioteca.
  • Se corrigió el uso recursivo de SRW-lock en Windows cuando se trabaja en modo MDBX_NOTLS (sin usar el almacenamiento local de subprocesos), se corrigió la generación de bootid en caso de cambio de hora del sistema, se mejoró la detección de WSL1 y WSL2, se agregó la capacidad de abrir una base de datos Plan 9 montada usando DrvFS.

Finalmente si estás interesado en poder conocer más al respecto sobre esta nueva versión, puedes consultar los detalles en el siguiente enlace.


from Desde Linux https://ift.tt/3jg6TwP
via IFTTT

La nueva version de cppcheck 2.6 ya fue liberada y estas son sus novedades

Se ha dado a conocer la liberación de la versión del analizador de código estático cppcheck 2.6, que permite detectar varias clases de errores en el código C y C++, incluso cuando se utiliza una sintaxis no estándar típica de los sistemas integrados.

Se proporciona una colección de complementos a través de los cuales se proporciona la integración de cppcheck con varios sistemas de desarrollo, integración continua y prueba, así como características tales como verificar el cumplimiento del código con el estilo de codificación.

Para analizar el código, se puede utilizar tanto su propio analizador como un analizador externo de Clang. También incluye un script donate-cpu.py para proporcionar recursos locales para realizar el trabajo de revisión colaborativa del código de los paquetes Debian.

El desarrollo de cppcheck se centra en identificar problemas asociados con el comportamiento indefinido y el uso de constructos que son peligrosos desde el punto de vista de la seguridad.

El objetivo también es minimizar los falsos positivos. Entre los problemas identificados : punteros a objetos inexistentes, división por cero, desbordamientos de enteros, operaciones de cambio de bit incorrectas, conversiones incorrectas, problemas con la memoria, uso incorrecto de STL, desreferenciación de punteros nulos, aplicación de verificaciones después de un acceso real a un búfer, desbordando los límites del búfer, utilizando variables no inicializadas.

Principales novedades de cppcheck 2.6

En esta nueva versión se han agregado diversas comprobaciones al núcleo del analizador, de entre las cuales se destaca la comprobación de la ausencia de una declaración de retorno en el cuerpo de la función, asi como también la de registros de datos superpuestos, definiciones de comportamiento indefinidas y también la comprobación para el valor que se compara está fuera del rango de la representación del valor del tipo.

Otra de las novedades que se destaca que es la optimización de copia no se aplica a return std::move (local);, además de que se agregó soporte para mostrar mensajes de diagnóstico en diferentes colores para plataformas Unix y que la etiqueta de biblioteca <smart-pointer> ahora puede contener una etiqueta <unique> para punteros inteligentes que tienen propiedad única. Ahora se emite la advertencia sobre enlaces colgantes a este tipo de punteros inteligentes.

Además, los controles de Misra C 2012 se han implementado en su totalidad, incluida la Enmienda 1 y la Enmienda 2, excepto las reglas 1.1, 1.2 y 17.3. El compilador debe realizar las comprobaciones 1.1 y 1.2. Un compilador como GCC puede comprobar 17.3.

De los demás cambios que se destacan de esta nueva versión:

  • El archivo no se puede abrir simultáneamente para leer y escribir en diferentes secuencias;
  • Análisis simbólico agregado para ValueFlow. Se utiliza un delta simple al calcular la diferencia entre dos variables desconocidas;
  • Las reglas utilizadas para la lista de tokens «definir» también pueden coincidir con #include;
  • La etiqueta de biblioteca <function> ahora puede contener una etiqueta <container> y, por lo tanto, funciones gratuitas que pueden aceptar contenedores como std :: size, std :: empty, std :: begin, std :: end, etc. puede especificar yeld o action para contenedores;
  • Se corrigieron problemas con el manejo del parámetro –cppcheck-build-dir;
    htmlreport ahora puede imprimir información sobre el autor (usando git blame);
  • Emisión ampliada de advertencias sobre variables que no son constantes, pero que pueden convertirse en constantes;
  • Se han corregido los errores y deficiencias acumulados del analizador.

Finalmente si estás interesado en conocer más al respecto sobre esta nueva versión, puedes consultar los detalles en el siguiente enlace.

¿Como instalar cppcheck en Linux?

Para quienes estén interesados en poder instalar cppcheck en su distribución de Linux, pueden seguir las instrucciones que compartimos a continuación.

Si eres usuario de Debian o cualquier otra distribución basada o derivada de esta como lo son Deepin o Ubuntu, pueden realizar la instalación directamente desde la terminal tecleando el siguiente comando:

sudo apt-get install cppcheck

Ahora para quienes son usuarios de Fedora y derivados de este, pueden realizar la instalación tecleando el siguiente comando:

sudo yum instalar cppcheck

O para quienes son usuarios de Arch Linux o cualquier otro derivado de este, pueden instalar con el siguiente comando:

sudo pacman -S cppcheck


from Desde Linux https://ift.tt/3mMf6cW
via IFTTT

Encontraron una vulnerabilidad en el servidor http Apache

Hace poco se dio a conocer la noticia de que se encontró un nuevo vector de ataque contra el servidor http Apache, que permaneció sin parches en la actualización 2.4.50 y permite el acceso a archivos desde áreas fuera del directorio root del sitio.

Además, los investigadores han encontrado una manera de que, en presencia de ciertas configuraciones no estándar, no solo lean los archivos del sistema, sino que también ejecuten remotamente su código en el servidor.

CVE-2021-41773 en Apache HTTP Server 2.4.50 era insuficiente. Un atacante podría usar un ataque de recorrido de ruta para asignar URL a archivos fuera de los directorios configurados por directivas similares a Alias. Si los archivos fuera de estos directorios no están protegidos por la configuración predeterminada habitual «requieren todos denegados», estas solicitudes pueden tener éxito. Si los scripts CGI también están habilitados para estos parches con alias, esto podría permitir la ejecución remota de código. Este problema solo afecta a Apache 2.4.49 y Apache 2.4.50 y no a versiones anteriores.

En esencia, el nuevo problema (ya catalogado como CVE-2021-42013) es completamente similar a la vulnerabilidad original (CVE-2021-41773) en 2.4.49, la única diferencia está en una codificación de caracteres diferente.

Y es que en particular, en la versión 2.4.50 se bloqueó la posibilidad de utilizar la secuencia «% 2e» para codificar un punto, pero se perdió la posibilidad de una doble codificación: al especificar la secuencia «%% 32% 65», el servidor decodificado en «% 2e», y luego en «.», es decir Los caracteres «../» para ir al directorio anterior se pueden codificar como «. %% 32% 65 /».

Ambos CVE son de hecho casi la misma vulnerabilidad de recorrido de ruta (la segunda es la solución incompleta para la primera). El recorrido de la ruta solo funciona desde un URI mapeado (por ejemplo, a través de las directivas Apache «Alias» o «ScriptAlias»). DocumentRoot solo no es suficiente

En cuanto a la explotación de una vulnerabilidad a través de la ejecución de código, esto es posible si mod_cgi está habilitado y se utiliza una ruta base en la que se permite la ejecución de scripts CGI (por ejemplo, si la directiva ScriptAlias ​​está habilitada o se especifica el indicador ExecCGI en la directiva Opciones).

Se menciona que un requisito previo para un ataque exitoso es también proporcionar explícitamente en la configuración de Apache acceso a directorios con archivos ejecutables, como / bin, o acceso a la raíz FS «/». Dado que normalmente no se proporciona dicho acceso, un ataque de ejecución de código es de poca utilidad para los sistemas reales.

Al mismo tiempo, el ataque a la obtención de contenido de archivos de sistema arbitrarios y textos fuente de scripts web que están disponibles para lectura para el usuario bajo el cual se ejecuta el servidor http sigue siendo relevante. Para llevar a cabo un ataque de este tipo, basta con tener un directorio en el sitio configurado utilizando las directivas «Alias» o «ScriptAlias» (DocumentRoot no es suficiente), como «cgi-bin».

Además de ello que menciona que el problema afecta principalmente a distribuciones continuamente actualizadas (Rolling Release) como lo son Fedora, Arch Linux y Gentoo, así como también a los ports de FreeBSD.

Mientras que las distribuciones de Linux que se basan en ramas estables de las distribuciones de servidor como lo son Debian, RHEL, Ubuntu y SUSE no son vulnerables. El problema no aparece si se deniega explícitamente el acceso a los directorios mediante la configuración » requerir todo denegado «.

También vale la pena mencionar que el 6 y 7 de octubre, Cloudflare registró más de 300 mil intentos de explotar la vulnerabilidad CVE-2021-41773 por día. La mayoría de las veces, como resultado de ataques automatizados, solicitan el contenido de «/cgi-bin/.%2e/.git/config», «/cgi-bin/.%2e/app/etc/local.xml», «/cgi-bin/.% 2e/app/etc/env.php» y «/cgi-bin/.%2e/%2e%2e/%2e%2e/etc/passwd».

El problema solo se manifiesta en las versiones 2.4.49 y 2.4.50, las versiones anteriores de la vulnerabilidad no se ven afectadas. Para corregir la nueva variante de la vulnerabilidad, se formó rápidamente el lanzamiento de Apache httpd 2.4.51.

Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.


from Desde Linux https://ift.tt/3iXXWYN
via IFTTT

La llegada de FLoC tendrá un ligero retraso, pero su llegada sera inevitable

Ya en varios artículos que hemos compartido aquí en el blog hemos hablado sobre FLoC la cual es una tecnología de Google que básicamente intercambia el seguimiento de usuarios individuales y la toma de huellas dactilares por identificación de grupo (cohorte) basada en historiales de navegación similares de miembros de ese grupo.

FLoC coloca a las personas en grupos en función de comportamientos de navegación similares, lo que significa que solo se utilizan «ID de cohorte» y no ID de usuario individuales para apuntar a ellos. El historial web y las entradas del algoritmo se guardan en el navegador, y el navegador muestra solo una «cohorte» que contiene miles de personas.

En enero de 2020, Google dijo que se estaba dando un plazo de dos años para bloquear las cookies de terceros, una forma común para que las empresas rastreen a las personas en su navegador Chrome. El plan de Google es evitar que las empresas de adware y otras organizaciones conecten las cookies de su navegador a sitios web que no operan:

«Después de un diálogo inicial con la comunidad web, estamos seguros de que, con la iteración y los comentarios continuos, los mecanismos de privacidad y los estándares abiertos como el Privacy Sandbox puede respaldar una web saludable y con publicidad de una manera que hará que las cookies de terceros sean obsoletas. Una vez que estos enfoques satisfagan las necesidades de los usuarios, editores y anunciantes, y desarrollen las herramientas para mitigar las soluciones, planeamos eliminar gradualmente el soporte de cookies de terceros en Chrome. Nuestra intención es hacerlo dentro de dos años. Pero no podemos hacerlo solos, y por eso necesitamos que el ecosistema participe en estas propuestas. Planeamos comenzar las primeras pruebas de origen a fines de este año, comenzando con la medición de conversión y continuando con la personalización.

Para hacerlo, el editor de Chrome propuso el aprendizaje federado de cohortes(FLoC) que forma parte de la zona de pruebas de privacidad. Los ingenieros de Chrome han trabajado con la industria a mayor escala, incluida la organización de estándares web W3C, en ideas de Sandbox que han presentado Google y otros actores de la tecnología publicitaria. Según Google, es probable que se exploren más a fondo algunas de estas ideas.

Posterior a ello diversas marcas y grupos de renombre se postularon en contra de FloC y en respuesta a la reacción de la industria, Google ha decidido retrasar la eliminación de la compatibilidad con cookies de terceros de Chrome. Muchos navegadores ahora bloquean las cookies de seguimiento de terceros, pero Google no iba a intervenir sin antes proteger su modelo de negocio, especialmente con FLoC. Sin embargo, ante las reacciones en cadena, tanto de los actores de la industria como de los políticos (por ejemplo, la encuesta de la UE dirigida a los servicios de tecnología publicitaria de Google ), Google dice «que ha quedado claro que se necesita más tiempo en todo el ecosistema para lograrlo».

Google ha afirmado haber recibido «comentarios sustanciales» de la comunidad web después de su primera prueba de FLoC, y ahora tomará un poco más de tiempo que el mecanismo se implemente a gran escala. Google dice que esto «dejará suficiente tiempo para el debate público sobre las soluciones adecuadas, el compromiso continuo con los reguladores y para que los editores y la industria de la publicidad migren sus servicios». Si bien FLoC es el principal argumento de Google para un usuario que rastrea el reemplazo de las cookies publicitarias, no es su única opción. La compañía dijo que «Chrome y otros han realizado más de 30 envíos, y cuatro de esos envíos están disponibles en Origin Trials».

Google ha actualizado su programa mensual de privacidad de la zona de pruebas para mostrar que la compañía pospuso las pruebas de FLoC desde el cuarto trimestre de 2021 (anunciado en julio) hasta el primer trimestre de 2022. Probando la API de FLEDGE, la nueva propuesta de Chrome para ayudar a los anunciantes a reorientar la publicidad sin Las cookies de terceros en la web también se están retrasando y no tendrán lugar hasta el primer trimestre de 2022.

Google ahora planea implementar FLoC en los navegadores a fines de 2022 (el segmento verde en la hoja de ruta a continuación), luego la fase de soporte de cookies de terceros a fines de 2023, durante un período de 3 meses.

El período de «Discusión», inicialmente previsto para finalizar en el tercer trimestre de 2021, durante el cual «las tecnologías y sus prototipos se discuten en foros como GitHub o grupos W3C», se ha ampliado hasta finales del cuarto trimestre de 2021. Esto también impacta la estimación de cuándo se espera que finalicen las pruebas, que ahora cambia desde el final del segundo trimestre hasta el final del tercer trimestre de 2022.

Además, las pruebas de las API que se encuentran en la categoría de «medir publicidad digital» también se han pospuesto para el primer trimestre de 2022.

Fuente: https://www.privacysandbox.com/


from Desde Linux https://ift.tt/3ACWu3M
via IFTTT

Ya fue liberada la nueva version de Arkime 3.1 (anteriormente conocido como Moloch)

Hace poco se dio a conocer el lanzamiento del sistema de captura, almacenamiento e indexación de paquetes de red Arkime 3.1, que proporciona herramientas para evaluar visualmente los flujos de tráfico y buscar información relacionada con la actividad de la red.

El proyecto fue desarrollado originalmente por AOL con el objetivo de crear un reemplazo abierto e implementable para las plataformas de procesamiento de paquetes de red comercial en sus servidores  que pueden escalar para manejar el tráfico a velocidades de decenas de gigabits por segundo.

Sobre Arkime

Para quienes desconocen de Arkime, déjenme decirles que anteriormente era conocido como Moloch el cual era un kit de herramientas para capturar e indexar el tráfico en formato PCAP estándar y también proporciona herramientas para un acceso rápido a los datos indexados. El uso del formato PCAP simplifica enormemente la integración con analizadores de tráfico existentes como Wireshark. La cantidad de datos almacenados está limitada solo por el tamaño de la matriz de discos disponible. Los metadatos de la sesión se indexan en un clúster basado en el motor Elasticsearch.

Para analizar la información acumulada se propone una interfaz web que permite la navegación, búsqueda y exportación de muestras. La interfaz web proporciona varios modos de visualización: desde estadísticas generales, mapas de conexión y gráficos visuales con datos sobre cambios en la actividad de la red hasta herramientas para estudiar sesiones individuales, analizar la actividad en el contexto de los protocolos utilizados y analizar datos de volcados de PCAP.

También se proporciona una API para permitir que las aplicaciones de terceros pasen datos de paquetes capturados en formato PCAP y sesiones analizadas en formato JSON.

Arkime tiene tres componentes básicos:

  1. Traffic Capture System es una aplicación C multiproceso para monitorear el tráfico, escribir volcados de PCAP en el disco, analizar los paquetes capturados y enviar metadatos de sesión (inspección de paquetes con estado) (SPI) y protocolos al clúster de Elasticsearch. Es posible el almacenamiento cifrado de archivos PCAP.
  2. Una interfaz web basada en la plataforma Node.js que se ejecuta en cada servidor de captura de tráfico y maneja las solicitudes relacionadas con el acceso a datos indexados y la transferencia de archivos PCAP a través de la API .
  3. Almacén de metadatos basado en Elasticsearch.

Principales novedades de Arkime 3.1

En esta nueva versión liberada uno de los cambios más importantes que se destaca es el cambio del nombre del proyecto, ya que como más arriba les comentaba el proyecto anteriormente era conocido como Moloch y los desarrolladores comenta que el proyecto ha experimentado un crecimiento y un cambio significativos y pensaron que era un buen momento para cambiar el nombre a Arkime. 

Otro de los cambios que se destaca es la interfaz de usuario completamente nueva para la configuración WISE, la creación y actualización de fuentes WISE y las estadísticas WISE. Esta es una nueva y poderosa herramienta para ayudar a los usuarios a comenzar con WISE o mejorar su servicio WISE sin tener que dedicar tiempo a la configuración o los archivos de origen.

Por otra parte, también se destaca que se agregó soporte para los protocolos IETF QUIC, GENEVE, VXLAN-GPE, además de que se agregó soporte para el tipo Q-in-Q (Double VLAN), que permite encapsular etiquetas VLAN en etiquetas de segundo nivel para expandir la cantidad de VLAN a 16 millones.

De los demás cambios que se destacan:

  • Se agregó soporte para el tipo de campo «flotante».
  • El escritor de Amazon Elastic Compute Cloud se ha trasladado para utilizar el protocolo IMDSv2 (Instance Metadata Service).
  • Refactorización del código para agregar túneles UDP.
  • Se agregó compatibilidad con elasticsearchAPIKey y elasticsearchBasicAuth.

Finalmente si estás interesado en conocer más al respecto de esta nueva versión, puedes consultar los detalles en el siguiente enlace.

Obtener Arkime

Para quienes esten interesados en poder obtener esta utilidad, deben saber que el código del componente de captura de tráfico está escrito en C y la interfaz está implementada en Node.js/JavaScript. El código fuente se distribuye bajo la licencia Apache 2.0. Se admite el trabajo en Linux y FreeBSD.

Los paquetes Ready están preparados para Arch, CentOS y Ubuntu y se pueden obtener desde el siguiente enlace.


from Desde Linux https://ift.tt/2YLgcgs
via IFTTT