libuv, una biblioteca multiplataforma utilizada en muchos proyectos para el soporte para E/S

libuv

libuv es una biblioteca de soporte multiplataforma con un enfoque en E/S asíncrona.

Hace poco se dio a conocer el lanzamiento de la nueva versión de la biblioteca libuv 1.45.0, la cual es ampliamente utilizada para multiplexación de conexiones y procesamiento de E/S asíncrono en muchos proyectos destinados al procesamiento de alto rendimiento de solicitudes de red y archivos, por ejemplo, en la plataforma Node.js, BIND 9 y Knot.

Para quienes desconocen de libuv, deben saber que esta es una biblioteca C multiplataforma que brinda soporte para E/S asíncrona basada en bucles de eventos. Es compatible con epoll Windows kqueue IOCP, puertos de eventos de Solaris y en Linux es una de las bibliotecas que brinda soporte a io_uring.

Sobre libuv

libuv está diseñado principalmente para su uso en Node.js, pero también lo utilizan otros proyectos de software. Originalmente era una abstracción en torno a libev o Microsoft IOCP, ya que libev no es compatible con IOCP en Windows.

La biblioteca permite organizar un bucle de eventos sin bloqueo utilizando métodos como epoll en Linux, kqueue en BSD y macOS, IOCP en Windows y puertos de eventos en Solaris

De las características que se destacan de libuv:

  • Bucle de eventos con todas las funciones respaldado por epoll, kqueue, IOCP, puertos de eventos
  • Sockets TCP y UDP asíncronos
  • Resolución DNS asíncrona
  • Operaciones asincrónicas de archivos y sistemas de archivos
  • Eventos del sistema de archivos
  • Código de escape ANSI controlado TTY
  • IPC con uso compartido de sockets, utilizando sockets de dominio Unix o canalizaciones con nombre (Windows)
  • Procesos secundarios
  • Grupo de subprocesos
  • Manejo de señales
  • reloj de alta resolucion
  • Primitivas de enhebrado y sincronización

Las funciones multiplataforma están disponibles para que las aplicaciones trabajen con conexiones de red TCP y UDP en modo asíncrono, resolución de DNS asíncrono, trabajo asíncrono con archivos, seguimiento de eventos en el sistema de archivos, organización de IPC para compartir sockets, organización de un grupo de subprocesos procesamiento de señales y uso de temporizadores de alta precisión.

La biblioteca también incluye primitivas para organizar la ejecución de subprocesos múltiples y la sincronización de subprocesos. Junto con el bucle de eventos, se utilizan dos primitivas básicas abstractas de alto nivel: «manejadores» para implementar objetos de larga duración que realizan múltiples operaciones y «solicitudes» para realizar solicitudes de corta duración.

Principales novedades de libuv 1.45

Una mejora clave en la nueva versión es la implementación de la tan esperada compatibilidad con la interfaz de E/ S asíncrona io_uring proporcionada por el kernel de Linux desde la versión 5.1.

Ademas de ello, tambien se destaca la compatibilidad con el sondeo de E/S y la capacidad de trabajar con y sin almacenamiento en búfer con la API io_uring, los desarrolladores del kernel intentaron abordar las deficiencias de la antigua interfaz aio. En términos de rendimiento, io_uring está muy cerca de SPDK y supera significativamente a libaio cuando el sondeo está habilitado.

En libuv, la interfaz io_uring se puede usar en plataformas Linux con kernel 5.1+ en primitivas de manipulación de archivos asincrónicos como lectura, escritura, fsync, fdatasync, stat, fstat y lstat. En otros sistemas operativos y sistemas con núcleos más antiguos, se sigue utilizando el grupo de subprocesos.

Se menciona que las pruebas de rendimiento han demostrado que el uso de io_uring en libuv puede lograr un aumento de rendimiento de 8 veces. El trabajo de agregar io_uring a libuv fue apoyado por el ISC (Internet Systems Consortium), que usa la biblioteca en cuestión en el servidor BIND DNS.

Otras de las mejoras de la nueva versión, destaca la configuración de un único tamaño de pila de 8 MB para el grupo de subprocesos en todas las arquitecturas y plataformas.

Tambien se destaca que se agregó una nueva API uv_metrics_info() para recopilar métricas, como el recuento de iteraciones en el ciclo de eventos, la cantidad total de eventos procesados ​​y la cantidad de eventos en espera en la cola en el momento en que se envió la solicitud.

Finalmente, si estás interesado en poder conocer más al respecto, debes saber que el código del proyecto está escrito en C y se distribuye bajo la licencia MIT. Puedes consultar los detalles en el siguiente enlace. 


from Desde Linux https://ift.tt/ulZeYWb
via IFTTT
No compartas fotos de tus hijos en redes sociales, los pones en riesgo

Una costumbre que se ha instaurado con las redes sociales es la de compartir nuestras vidas a través de imágenes o vídeos. Pero lo que quizás no te hayas planteado es que las fotos familiares que subiste a Facebook podrían acabar en manos de un pedófilo.

Un estudio de la Universitat Oberta de Catalunya (UOC) reveló que la mayoría del material que se les confisca a los agresores son fotografías comunes de niños.

De acuerdo con Cadena SER , el 72% del material en posesión de pedófilos son imágenes no sexualizadas de niños. Estos agresores obtienen el contenido de álbumes familiares y otras fuentes legítimas. Muchos padres comparten momentos de la vida de sus hijos sin percatarse de que dicho contenido podría acabar en el computador de un consumidor de pornografía infantil.

Según Irene Montiel, profesora de Estudios de Derecho y Ciencia Política de la UOC:

Tenemos la impresión de que las personas que coleccionan imágenes de abuso sexual infantil solo recopilan las más explícitas. Pero la realidad es que las imágenes no sexualizadas de niños están presentes en las colecciones de los agresores duales.

Este tipo de agresores son los más peligrosos, ya que abusan sexualmente de menores.

La investigación señala que el 89% de las familias comparten contenido de sus hijos en Facebook, Instagram o TikTok al menos una vez al mes. Con los bebés, el porcentaje es alarmante, ya que el 81% aparece en Internet antes de cumplir seis meses.

Los padres que publican fotos de la ecografía, el nacimiento o los primeros pasos no solo están violando la futura identidad digital de sus hijos, sino que también los están poniendo en riesgo.

Las redes sociales, cómplices de los pedófilos

Aunque algunas redes sociales como Facebook o YouTube afirman tener mecanismos para combatir la pedofilia, lo cierto es que no son suficientes.

En febrero de 2019, un youtuber reveló que el algoritmo de YouTube sugería videos de menores con poca ropa. El contenido estaba al alcance de todos y la sección de comentarios estaba repleta de frases ofensivas o enlaces a sitios de pornografía infantil.

La empresa respondió con un nuevo sistema de clasificación para identificar y eliminar comentarios depredadores. De la misma manera, YouTube desactivó los comentarios en la mayoría de los vídeos de menores que podrían atraer a los agresores.

Desafortunadamente, esta medida fue temporal y solo se aplicó a algunos creadores de contenido.

Hace unos meses, Pinterest estuvo en el centro de la polémica después de que una investigación descubriera que la red social es un refugio para pedófilos. El algoritmo sugiere fotos de menores sexualizados y permite comentarios de hombres mayores. La empresa respondió eliminando algunos perfiles y tableros, prometiendo una función para denunciar imágenes sugerentes sexualmente.

La responsabilidad recae en los padres

La automatización de los sistemas de moderación en las redes sociales ha hecho que sea imposible implementar un sistema eficaz contra los pedófilos. Aunque podríamos culpar a Mark Zuckerberg y otros ejecutivos por esto, la responsabilidad sobre los menores recae en los padres. Son ellos quienes deben establecer las pautas sobre qué contenido se comparte en las plataformas.

Los datos proporcionados por la investigación de la Universitat Oberta de Catalunya dejan claro que los agresores prefieren el contenido cotidiano.

Las fotos de una visita al museo o al parque pueden parecer normales para ti o tu familia, pero no para un pedófilo que las almacena en el disco duro de su ordenador.

Así las cosas, antes de subir una imagen de tus hijos a las redes sociales, considera el riesgo que esto implica.

El cargo No compartas fotos de tus hijos en redes sociales, los pones en riesgo apareció primero en Tecnovedosos.


source https://tecnovedosos.com/compartir-fotos-hijos-redes-sociales/

Pot: Una pequeña y útil app libre multiplataforma para traducir

Pot: Una pequeña y útil app libre multiplataforma para traducir

Pot: Una pequeña y útil app libre multiplataforma para traducir

Una de las cosas que buscamos o necesitamos muchos alrededor del mundo, suelen ser las aplicaciones y plataformas de servicios de traducción en línea y fuera de línea. Sin importar si somos jóvenes, adultos o viejos, estudiantes o profesores, aprendices o profesionales, todos solemos tanto desde un ordenador de escritorio o portátil como desde un dispositivo móvil o tableta, necesitar saber que significa todo aquello que vemos y leemos en otro idioma.

Por ello, en oportunidades anteriores hemos abordado algunas de las aplicaciones libres y abiertas más conocidas y usadas sobre GNU/Linux para traducir. Por ejemplo, Crow Translate ha sido una de nuestras apps favoritas reseñadas para dicho fin. La cual, en ese entonces, hace más de 2 años, estaba en la versión 2.2.0, mientras que hoy en día va por la versión 2.10.5. Sin embargo, hoy aprovecharemos para dar a conocer otra bastante novedosa e interesante, llamada «Pot» (Traductor de Pylogmon), que además de ser libre y abierta, es multiplataforma, moderna y flexible.

Crow Translate 2.6.2: Nueva versión disponible del útil traductor para Linux

Crow Translate 2.6.2: Nueva versión disponible del útil traductor para Linux

Pero, antes de iniciar la lectura de este post sobre la interesante y novedosa aplicación de traducción multiplataforma llamada «Pot», les recomendamos la anterior publicación relacionada:

Pot (Traductor de Pylogmon): App libre, abierta y gratuita

Pot (Traductor de Pylogmon): App libre, abierta y gratuita

¿Qué es Pot?

Lo primero, que resalta de esta aplicación «Pot» al explorar su sitio web oficial es que es de origen chino. Por lo que, necesitaremos traducirla al inglés o español u otro idioma necesario para conocer un poco más sobre ella. Sin embargo, en su sección oficial en GitHub puede conseguirse información directamente en inglés. Pero, en ambos se describe a la misma de forma muy breve y simple de la siguiente forma:

Pot (Traductor de Pylogmon) es un software multiplataforma para la traducción de textos.

Otra cosa que destacada de la misma, es que es una aplicación relativamente pequeña en tamaño, por lo que es fácil de descargar e instalar. Además, está desarrollada principalmente en JavaScript y Rust. Y un dato gracioso sobre la misma es que debió llamarse Top (por sus siglas en inglés para Translator of Pylogmon). Pero, su desarrollador tuvo que optar por usar su nombre de forma invertida para no entrar en conflictos con la aplicación de terminal (CLI) llamada Top, ampliamente conocida en Linux.

Características de Pot

Características

Entre las informaciones técnicas y sus características más destacadas podemos mencionar las siguientes:

  1. Actualmente, va por la actual versión estable número 0.5 de fecha del primero de junio de 2023.
  2. Ofrece instaladores para Windows, macOS y GNU/Linux. Y para este último, en los formatos siguientes: «.deb», «.AppImage» y «.tar.gz».
  3. Permite traducir texto introduciendo el mismo a través de su interfaz principal, seleccionando el texto sobre cualquier aplicación o sitio web texto o a través del Portapapeles del Sistema Operativo.
  4. Para GNU/Linux específicamente, ofrece un buen soporte para Wayland (sobre KDE y Gnome). Además, incluye la posibilidad de traducir las capturas de pantalla, gracias a su compatibilidad con reconocimiento óptico de caracteres.
  5. Por último, posee un amplio soporte multilingüe a la hora de traducir textos a otros idiomas. Sin embargo, su interfaz gráfica viene por defecto en chino al ejecutarse, pero puede colocarse en idioma inglés. Y también puede importar texto a Anki/Eudic (y hasta permite agregar más opciones).

Uso y pantallazos

Uso y pantallazos

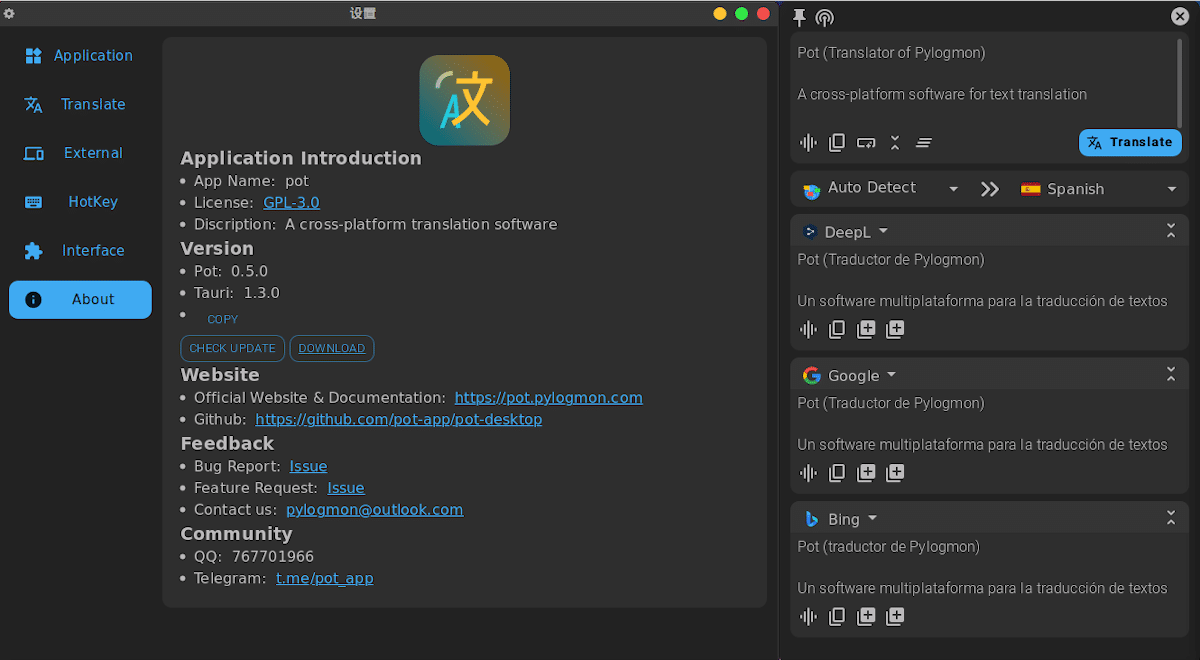
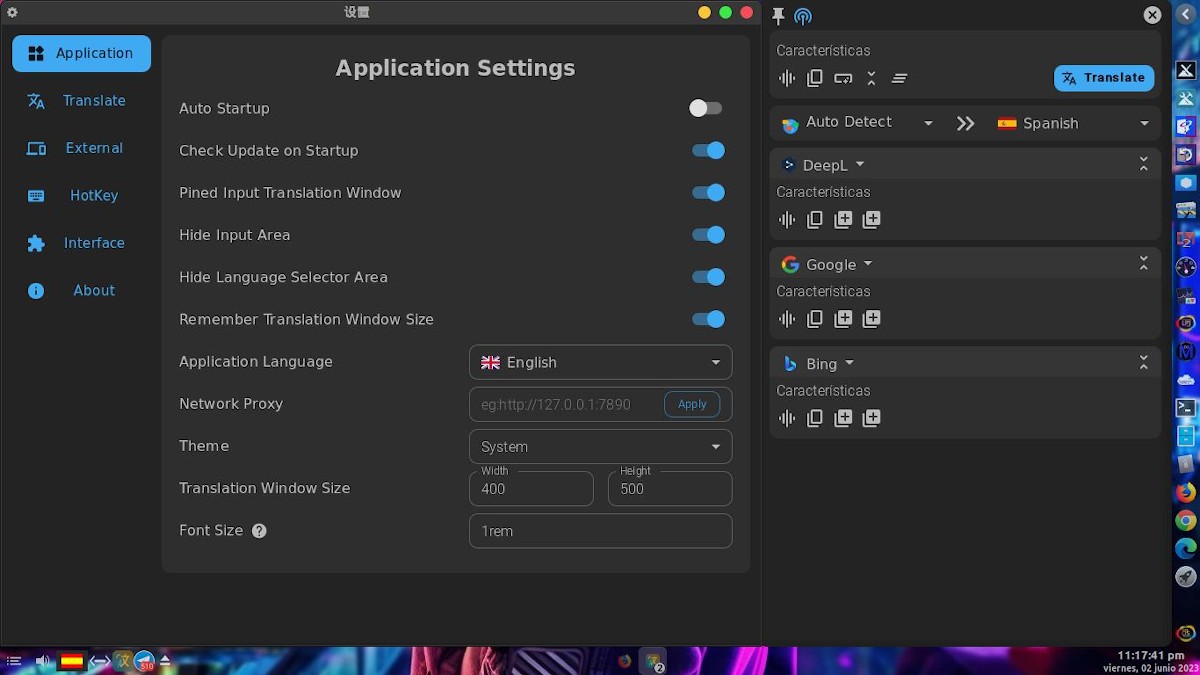
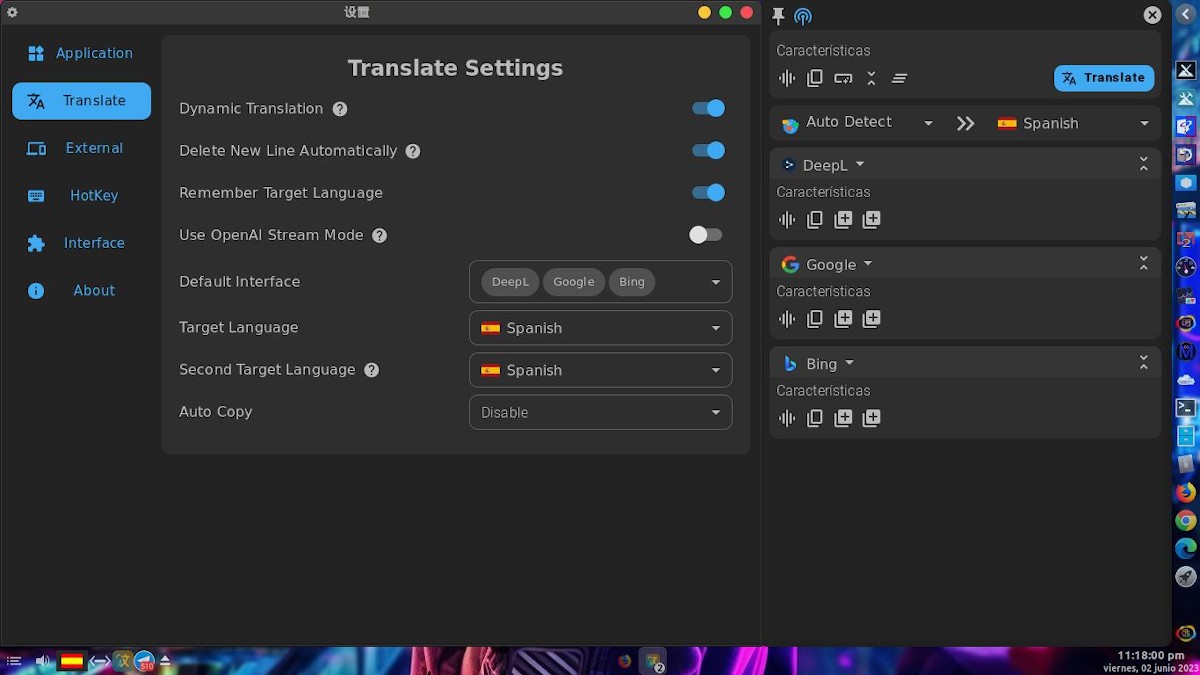
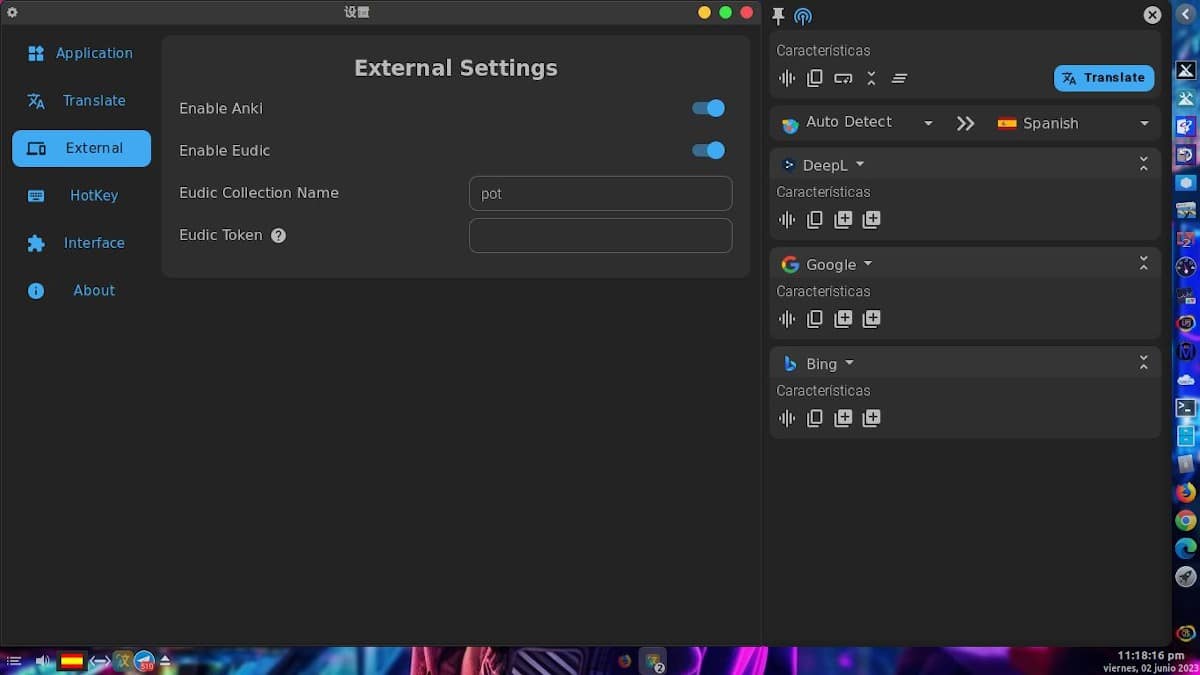
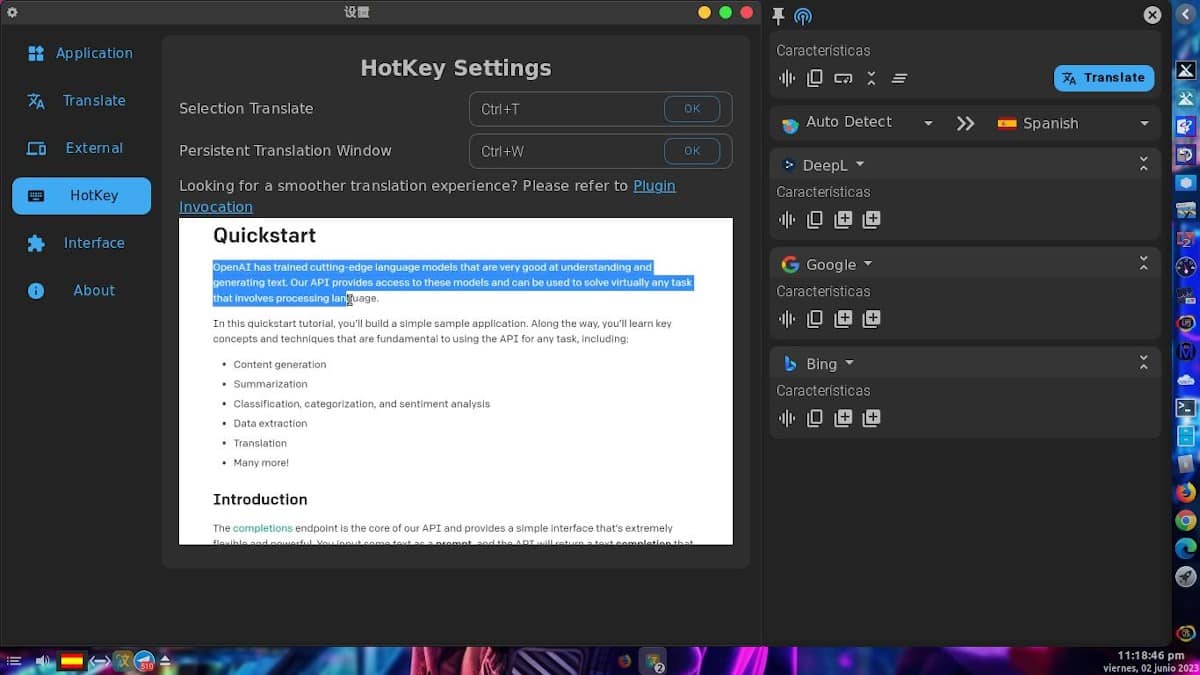
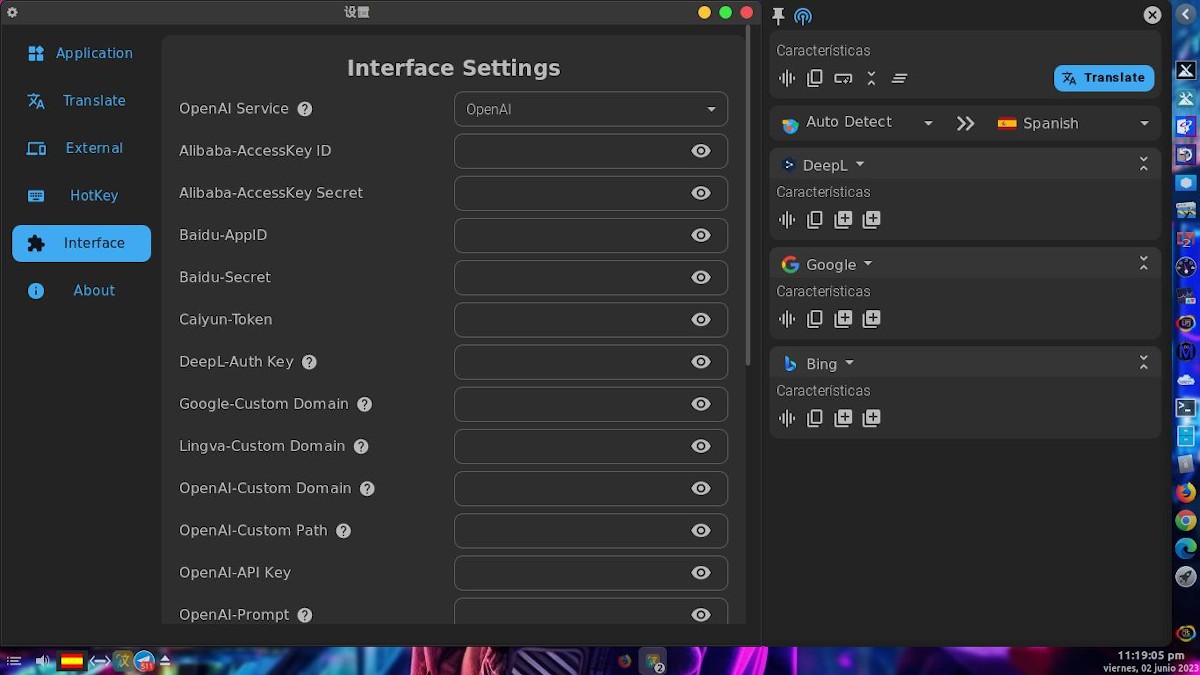
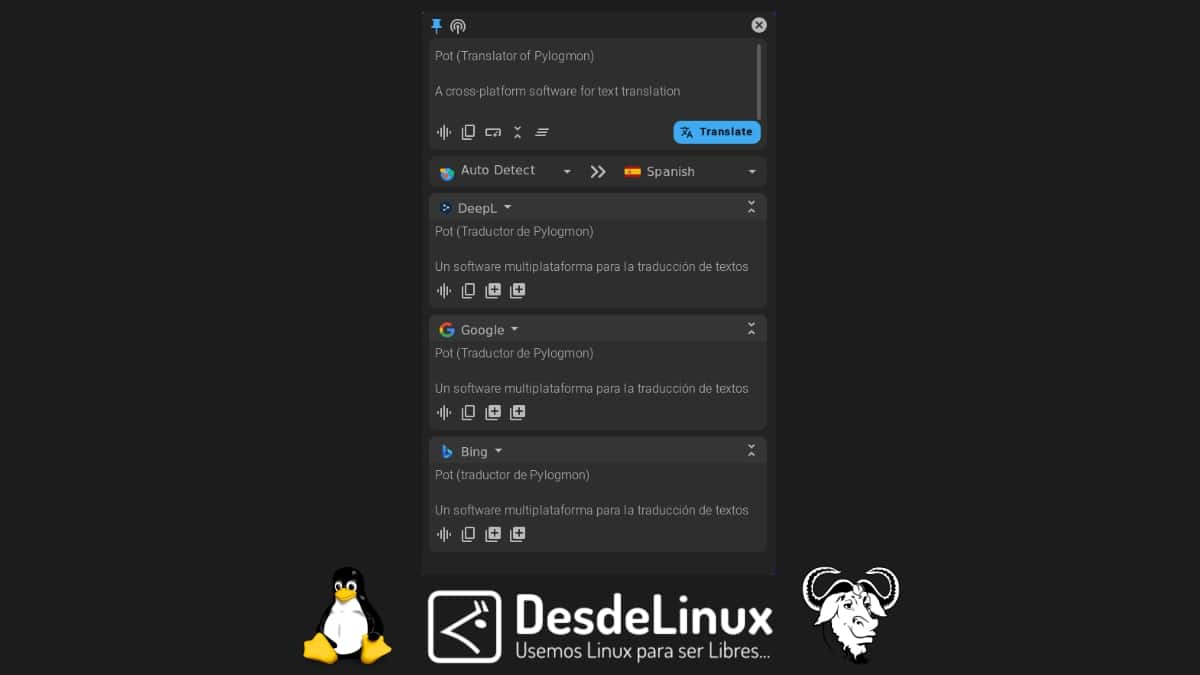
En esta nueva oportunidad y como de costumbre, hemos probado la aplicación Pot sobre nuestro habitual Respin MilagrOS 3.1 (MX-21 / Debian-11), y usando su instalador o ejecutable en formato .AppImage. Y una vez descargada y ejecutada la aplicación, las imágenes siguientes muestran su hermosa y muy funcional interfaz gráfica de usuario (GUI).

Probando la aplicación - pantallazo 1

Probando la aplicación - pantallazo 2

Probando la aplicación - pantallazo 3

Probando la aplicación - pantallazo 4

Probando la aplicación - pantallazo 5

En lo personal, me ha gustado mucho, ya que, de forma fácil y rápida puedo obtener la traducción simultánea desde diversas fuentes de traducción de un mismo contenido transcrito directamente, convertido mediante un simple atajo de teclado desde cualquier aplicación y sitio web o a través del portapapeles del sistema operativo.

Resumen: Banner post 2021

Resumen

En resumen, esta interesante y novedosa aplicación de traducción multiplataforma llamada «Pot», aparte de cumplir muy bien con su objetivo de traducir contenido (texto) de aplicaciones, sitios webs, el portapapeles o directamente sobre su interfaz, tiene como ventajas inigualables el ser libre, abierta, gratuita y multiplataforma. Por ello, sin duda alguna te invitamos a probarla, para que luego nos cuentes tu opinión sobre su funcionamiento y sus características para el conocimiento y utilidad de todos.

Por último, recuerda visitar nuestra «página de inicio» y unirte a nuestro canal oficial de Telegram para explorar más noticias, guías y tutoriales. Y también, ha este grupo para hablar y obtener más información sobre cualquier tema TI aquí abordado.


from Desde Linux https://blog.desdelinux.net/pot/
via IFTTT

Chrome 114 ya fue liberado y estas son sus novedades

Google Chrome

Google Chrome es un navegador web de código cerrado​​ desarrollado por Google

Google Chrome 114 es una nueva versión principal del popular navegador web y en este nuevo lanzamiento son pocas las novedades que se destacan, pero que de los cambios implementados hay algunos que vale la pena mencionar-

Y es que uno de los principales cambios en Chrome 114 es el cambio de usar el almacén de certificados del sistema operativo al almacén de certificados de Chrome. 

Otro de los cambios que se destaca de la nueva versión, es que se ha iniciado con la promoción gradual (para algunos usuarios) de la interfaz de la barra lateral actualizada para trabajar con marcadores, en la que han aparecido funciones como la configuración de filtros, el cambio del método de clasificación y la edición en el lugar.

Por la parte de las mejoras para desarrolladores, podremos encontrar que la API del panel lateral se implementó para permitir que los complementos basados ​​en la tercera versión del manifiesto agreguen sus propios paneles a la interfaz de la barra lateral integrada.

Ademas de ello, en Chrome 114 si los sitios cuentan con la capacidad de usar la API de token de estado privado para separar diferentes usuarios sin usar identificadores entre sitios y para pasar información de identidad de usuario entre diferentes contextos.

En la práctica, la API puede ser útil para separar los bots de los visitantes reales sin pasar explícitamente los datos de identificación. La esencia de trabajar con la API es que un determinado sitio en el que el usuario haya pasado la autenticación o la verificación de captcha puede generar un token almacenado en el lado del navegador. Este token puede ser utilizado por otros sitios para verificar que el usuario es un humano y no un bot. Para controlar el acceso a la nueva API, se proporciona la opción de verificación automática en la configuración.

Se agregó la API NotRestoredReason, que permite averiguar el motivo por el que no se restauró el contenido de la página desde el caché después de presionar los botones Atrás y Adelante, ademas de que se agregó un evento scrollend que se activa cuando el usuario termina de desplazarse (cuando la posición deja de cambiar) en los objetos Elemento y Documento.

En Chrome 114 el administrador de contraseñas recibió un rediseño en la interfaz que se muestra al hacer clic en el icono en la barra de direcciones, ademas de que ahora está diseñado como una aplicación PWA. De los otros cambios que se realizaron se destaca que se ha agregado un botón para abrir el administrador de contraseñas en el menú de primer nivel del navegador.

Se ha agregado soporte para la API Background Blur, que permite utilizar las capacidades proporcionadas por la plataforma para desenfocar el fondo de las imágenes y videos recibidos de la cámara (útil para aplicaciones web de videoconferencia).

De los demás cambios que se destacan de esta nueva version:

  • Las pestañas antiguas se agrupan en Pestañas inactivas en la cuadrícula de pestañas en iPhone y iPad.
  • La propiedad exclusionFilters se agregó al método navigator.bluetooth.requestDevice() para permitir la exclusión de ciertos dispositivos de la interfaz proporcionada por el navegador para seleccionar dispositivos Bluetooth disponibles.
  • Se mejoró la verificación de contraseñas en iOS para averiguar si las contraseñas se consideran inseguras.
    Prueba de una nueva experiencia en el panel lateral de Marcadores en Chrome que admite el filtrado, la clasificación y la edición.
  • La función Navegación segura de Chrome, si se establece en Estándar o Mejorada, desempaquetará recursivamente las descargas de archivos anidados ahora para mejorar la protección contra el malware que usa archivos anidados.
  • La propiedad CSS «overflow» ya no maneja el valor «overlay» por separado, que ahora es idéntico al valor «auto».
    Se agregó soporte para depurar formularios de autocompletar en el panel Elementos y la pestaña Problemas.
  • El panel Grabador ofrece la posibilidad de agregar afirmaciones durante la grabación.
  • El panel Rendimiento se ha ampliado para analizar el rendimiento e identificar cuellos de botella. Se eliminó la capacidad de invocar el panel de JavaScript Profiler, que anteriormente estaba en desuso.
  • WebAssembly agrega soporte para las nuevas instrucciones de procesamiento constante i32.add, i32.sub, i32.mul, i64.add, i64.sub e i64.mul.
  • Se han realizado mejoras en las herramientas para desarrolladores web.
  • Se proporciona la capacidad de depurar código C y C++ de aplicaciones WebAssembly para las que hay datos de depuración en formato DWARF.
  • Entre otras cosas, admite la configuración de puntos de interrupción y la visualización de nombres de funciones C/C++.

¿Como instalar Google Chrome en Linux?

Si estás interesado en poder instalar esta nueva versión de este navegador web y aún no lo tienes instalado, puedes descargar el instalador que se ofrece en paquetes deb y rpm en su sitio web oficial.

El enlace es este.


from Desde Linux https://ift.tt/mdsrKED
via IFTTT

Git 2.41 ya fue liberado y estas son sus novedades

Git 2.41

Git 2.41 implementa mejoras en el manejo de repositorios

Después de tres meses de desarrollo, se dio a conocer el lanzamiento de la nueva versión del sistema de control de código fuente distribuido Git 2.41. En comparación con la versión anterior, se aceptaron 542 cambios en la nueva versión, preparada con la participación de 95 desarrolladores, de los cuales 29 participaron en el desarrollo por primera vez.

Para quienes desconocen de Git, deben saber que es uno de los sistemas de control de versiones más populares, fiables y de alto rendimiento que proporciona herramientas de desarrollo no lineal flexibles basadas en bifurcaciones y fusiones de bifurcaciones.

Principales novedades de Git 2.41

En esta nueva versión destaca que se ha mejorado el manejo de objetos «unreachable» a los que no se hace referencia en el repositorio (no se hace referencia a ramas o etiquetas). El recolector de basura elimina los objetos, pero permanecen en el repositorio durante un cierto tiempo antes de eliminarlos para evitar condiciones de carrera.

Para realizar un seguimiento del período de los objetos, es necesario vincularles etiquetas con el tiempo de cambio de objetos similares, lo que no permite almacenarlos en un archivo de paquete, en el que todos los objetos tienen un tiempo de cambio común.

Anteriormente, cada objeto se almacenaba en un archivo separado, lo que generaba problemas si había una gran cantidad de objetos nuevos que aún no estaban sujetos a eliminación. En la nueva versión, Cruft Packs se utiliza de forma predeterminada para empaquetar objetos «unreachable«, que permite almacenar todos los objetos en un archivo de paquete y reflejar los datos sobre el tiempo de modificación de cada objeto en una tabla separada almacenada en un archivo con la extensión «.mtimes» y vinculado mediante un archivo de índice con el Extensión «.idx».

Otro de los cambios que se destaca de esta nueva versión, es que está habilitado el mantenimiento de revindex en el disco para los archivos del paquete. Cuando se probó en los repositorios Torvalds/Linux, el uso de un índice inverso se menciona que permitió acelerar las operaciones «git push» que consumen muchos recursos en 1,49 veces, y las operaciones simples, como calcular el tamaño de un solo objeto usando «git cat- file –batch=’%(objectsize:disk) ‘» 77 veces.

El índice inverso incluido en la nueva versión tiene como objetivo agilizar el proceso de determinación de la identificación del objeto a partir de la información sobre la ubicación del objeto en el archivo del paquete. La operación de construir un índice se reduce a construir una matriz de pares de «posición de objeto» y ordenarla por posición, lo que puede llevar mucho tiempo para archivos de paquetes grandes.

Por ejemplo, la operación de mostrar el contenido de los objetos, que usa un índice directo, fue 62 veces más rápida que la operación de mostrar el tamaño de los objetos, para los cuales no se indexaron los datos de relación de posición a objeto. Después de usar el índice inverso, estas operaciones comenzaron a tomar aproximadamente el mismo tiempo. Los índices inversos también le permiten acelerar la operación de envío de objetos al ejecutar comandos de búsqueda y envío mediante la transferencia directa de datos preparados desde el disco.

Tambien se destaca que en Git 2.41 se agregó soporte para pasar encabezados WWW-Authenticate entre el controlador de credenciales y el servicio de autenticación al protocolo » asistente de credenciales » que se usa para pasar credenciales cuando se accede a repositorios restringidos. La compatibilidad con el encabezado WWW-Authenticate permite que los parámetros de alcance de OAuth se pasen a un acceso de usuario separado de manera más granular a los repositorios y delimitan los alcances disponibles para las solicitudes.

De los demás cambios que se destacan de la nueva versión:

  • Se agregó la opción de formato «%(ahead-behind:<base>)» al comando for-each-ref, que permite obtener información de inmediato sobre la cantidad de confirmaciones presentes o ausentes en una determinada rama, en relación con otra rama.
  • Se agregó la opción «–porcelain» al comando «git fetch», que genera una salida en el formato «<flag> <old-object-id> <new-object-id> <local-reference>», menos legible, pero más conveniente para analizar en scripts.
  • Se agregó la configuración «fetch.hideRefs» para acelerar las operaciones «git fetch» ocultando parte de las referencias en el repositorio local en la etapa de verificación de que el servidor envió el conjunto completo de objetos, lo que ahorra tiempo al limitar la verificación solo a los servidores de la que se recuperan directamente los datos.
    El comando «git fsck» implementa la capacidad de verificar corrupción, coincidencia de suma de verificación y validación de valores en mapas de bits de accesibilidad e índices inversos.
  • El comando «git clone –local» ahora muestra un error al intentar copiar desde un repositorio que contiene enlaces simbólicos dentro de $GIT_DIR.

Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.


from Desde Linux https://ift.tt/iylGWpg
via IFTTT

¿Pronóstico de tsunamis? Conoce GUARDIAN, el sistema pionero de la NASA

La NASA ha desarrollado un innovador sistema capaz de predecir un tsunami con hasta una hora de antelación. Este mecanismo de monitoreo se nutre de los datos de GPS recopilados por diversos satélites para «percibir» el estruendo que estos eventos naturales generan en la atmósfera.

Este sistema ha recibido el nombre de GUARDIAN, un acrónimo inglés que se traduce como: Red de Alerta e Información de Desastres en Tiempo Real de la Alta Atmósfera GNSS. El sistema procesa los datos de múltiples conjuntos de satélites GPS y otros satélites de navegación que orbitan alrededor de nuestro planeta. En conjunto, estos grupos se conocen como sistemas globales de navegación por satélite o GNSS.

Cuando se trata de alertar con antelación, cada segundo es vital, afirmó la agencia espacial de Estados Unidos en un comunicado oficial. Además, informó que un equipo de científicos del Laboratorio de Propulsión a Chorro de la NASA está supervisando el proyecto.

Es un método innovador para detectar, desde las alturas de la atmósfera, las olas más letales del océano.

Según la NASA, durante un tsunami, amplias áreas de la superficie del océano pueden subir y bajar casi simultáneamente. Este movimiento desplaza una considerable cantidad de aire, que se propaga en todas direcciones en forma de ondas sonoras y gravitacionales de baja frecuencia. Estas ondas alcanzan la capa más alta de la atmósfera en cuestión de minutos, y usualmente distorsionan las señales de los satélites. Y aquí radica el quid de la cuestión.

Estas distorsiones pueden ser utilizadas para salvar vidas. «En lugar de interpretarlo como un error, lo utilizamos como datos para identificar peligros naturales», explicó Léo Martire, científico del laboratorio encargado del desarrollo de GUARDIAN.

El sistema de la NASA es uno de los más rápidos en detectar tsunamis

Este innovador sistema de alerta todavía está en fase de pruebas. Los resultados casi instantáneos de GUARDIAN deben ser analizados por expertos para confirmar la posible presencia de un tsunami. A pesar de esto, esta herramienta de la NASA ya es una de las más veloces en su categoría.

El dispositivo de la NASA puede producir una especie de imagen instantánea de los estruendos que generan los tsunamis al alcanzar la ionosfera en solo 10 minutos. Esto le permitiría emitir una alerta temprana hasta una hora antes, dependiendo de la distancia entre el origen del tsunami y la costa.

GUARDIAN se está poniendo a prueba en la zona geológicamente más activa del Cinturón de Fuego del Océano Pacífico. Según la Administración Nacional Oceánica y Atmosférica (NOAA), cerca del 78% de los más de 750 tsunamis confirmados entre 1900 y 2015 tuvieron lugar en esta región. Actualmente, el sistema monitorea algo más de la mitad de esta área en el Pacífico.

Además, el equipo está trabajando en una página web que permitirá a los expertos monitorear el estado de la ionosfera casi en tiempo real. La intención es proporcionar enlaces individuales a las estaciones de satélite de la red GNSS. Así, los usuarios podrán acceder a los datos de unas 90 estaciones alrededor del Cinturón de Fuego del Pacífico.

La meta final es expandir la cobertura y mejorar el sistema. El enfoque de la NASA es automatizar el sistema para detectar tsunamis y otros peligros, como erupciones volcánicas y terremotos.

El cargo ¿Pronóstico de tsunamis? Conoce GUARDIAN, el sistema pionero de la NASA apareció primero en Tecnovedosos.


source https://tecnovedosos.com/pronostico-tsunamis-guardian-nasa/

LibreSSL 3.8.0 llega con muchos cambios y mejoras

LibreSSL

LibreSSL es una bifurcación de OpenSSL desarrollada por el proyecto OpenBSD .

Los desarrolladores del proyecto OpenBSD dieron a conocer hace poco el lanzamiento de la edición portátil del paquete «LibreSSL 3.8.0», versión en la cual se han realizado diversos cambios y mejoras enfocadas en la estabilidad y compatibilidad.

Para quienes desconocen de LibreSSL, deben saber que esta es una implementación de código abierto del protocolo TLS que desarrolla una bifurcación de OpenSSL destinada a proporcionar un mayor nivel de seguridad. LibreSSL se desarrolló inicialmente como un reemplazo previsto para OpenSSL en OpenBSD y se transfirió a otras plataformas una vez que se estabilizó una versión simplificada de la biblioteca.

El proyecto LibreSSL se centra en el soporte de alta calidad para los protocolos SSL/TLS con la eliminación de funciones innecesarias, la adición de funciones de seguridad adicionales y una limpieza y reelaboración significativas del código base.

Principales novedades de LibreSSL 3.8.0

La versión de LibreSSL 3.8.0 se considera una versión experimental que desarrolla funciones que se incluirán con OpenBSD 7.4. Al mismo tiempo, se formaron versiones estables de LibreSSL 3.6.3 y 3.7.3, en las que se corrigieron varios errores.

En esta nueva versión que se presenta de LibreSSL 3.8.0 se destaca que se mejoro la compatibilidad de endian.h con las macros hto* y *toh, ademas de que se agregó el soporte para SHA-2 y SHA-3 truncados y se ha comenzado el proceso de limpieza y reelaboración del código SHA interno.

Otro de los cambios que se destacan son las funciones internas reescritas BN_exp() y BN_copy(), ademas de que se reemplazó la implementación de la función BN_mod_sqrt().

Ademas de ello, tambien se destaca que se agregaron las instrucciones del ensamblador para la arquitectura AMD64 usan las instrucciones endbr64 (Terminate Indirect Branch).

Tambien se destaca que se agregó una solución para un cambio mal pensado en OpenSSL 3 que rompió el soporte de separación de privilegios en libtls, ademas de que fue portado el código de BoringSSL para verificar las reglas definidas en RFC 5280 y que se continúa con la traducción de libcrypto para usar las interfaces CBB (bytebuilder) y CBS (bytestring).

Por otra parte, se destaca que se importó el código de verificación de políticas RFC 5280 de BoringSSL y se usó
para reemplazar el antiguo código de tiempo exponencial, ademas de que se eliminó el soporte para GF2m: BIGNUM ya que no admite la extensión binaria, se eliminaron la mayoría de los símbolos públicos que quedaron obsoletos en OpenSSL 0.9.8.

De los demás cambios que se destacan de esta nueva versión:

  • Se eliminó la API pública X9.31 (RSA_X931_PADDING aún está disponible).
  • Se eliminó el modo de robo de texto cifrado.
  • Se eliminó la compatibilidad con SXNET y NETSCAPE_CERT_SEQUENCE, incluida la
    comando openssl(1) nseq.
  • Compatibilidad con certificado de proxy descartado (RFC 3820).
  • Se eliminaron POLICY_TREE y sus estructuras relacionadas y API.
  • Corrección de la comprobación de errores de i2d_ECDSA_SIG() en ossl_ecdsa_sign().
  • Detección fija de operaciones extendidas (XOP) en hardware AMD.
  • Se corrigió el manejo de errores en tls_check_common_name().
  • Se añadió la invalidación de puntero faltante en SSL_free().
  • Se corrigieron X509err() y X509V3err() y sus versiones internas.
  • Cobertura de prueba significativamente mejorada de BN_mod_sqrt() y GCD.
  • Como siempre, se agrega nueva cobertura de prueba a medida que se corrigen errores y subsistemas
    se limpian.

Finalmente si estás interesado en poder conocer más al respecto, puedes consultar los detalles en el siguiente enlace.

¿Como instalar la nueva versión de LibreSSL?

Para los interesados en poder instalar esta nueva versión, deben saber que de momento no ha llegado a la mayoría de las distribuciones de Linux por lo que la instalación en este momento disponible es realizado la compilación del paquete por su cuenta.

Pero no te preocupes, la compilación de LibreSSL es muy sencilla y para ello solo tienes que abrir una terminal y ejecutar los siguientes comandos (debes contar con las siguientes dependencias automake, autoconf, git, libtool, perl y git).

Lo primero es obtener el código fuente, lo cual puedes hacer con este comando:

git clone https://github.com/libressl/portable.git


Hecho esto ahora vamos a preparar el camino para realizar la compilación, para ello entramos la carpeta que contiene el código fuente de LibreSSL y vamos a teclear:

cd portable
./autogen.sh
./dist.sh


Hecho esto procedemos a realizar la compilación con:

./configure
make check
make install


O si prefieren hacerlo con CMake:

mkdir build
cd build
cmake ..
make
make test


from Desde Linux https://ift.tt/eYDq32b
via IFTTT